
Computer Vision · Bild und Text
Multimodale KI im Unternehmen: Bilder, Dokumente und Text in einem System
Viele Abläufe im Unternehmen bestehen nicht nur aus Text: Fotos von Schäden, gescannte Lieferscheine, Zählerstände, Etiketten, Formulare. Multimodale Modelle verstehen Bild und Text gemeinsam und können solche Aufgaben ohne große Trainingsdatensätze übernehmen. Wo das heute trägt und wo nicht, zeigt dieser Überblick.
 Aleksandra Osztynowicz
Das Wichtigste in Kürze
- Multimodale Modelle verarbeiten Text, Bilder und oft auch Audio in einem Modell und beantworten Fragen zu dem, was sie sehen.
- Typische Einsatzfelder sind Dokumentenverarbeitung, Prüfung von Fotos, Ablesen von Anzeigen und Kontrolle von Verpackung oder Montage.
- Der große Vorteil: Anforderungen lassen sich in Worten beschreiben, und Prototypen entstehen ohne Tausende beschriftete Beispiele.
- Für den Produktivbetrieb braucht es Tests auf eigenen Daten. In der industriellen Prüfung sind spezialisierte Verfahren oft noch genauer.
Was multimodale Modelle sind
Klassische neuronale Netze sind auf eine Datenart spezialisiert, etwa Bilder oder Text. Multimodale Modelle verbinden mehrere Datenarten in einem System: Sie sehen ein Foto, lesen eine Anweisung dazu und antworten in Text. Damit werden Aufgaben möglich, die bisher mehrere getrennte Modelle brauchten, etwa ein Bild beschreiben, Fragen zu einem Bild beantworten oder Text aus einem Dokument im Zusammenhang verstehen.
Für Unternehmen ist vor allem eines neu: Anforderungen lassen sich beschreiben. Statt Tausende Beispiele für „korrekt montiert“ zu beschriften, erklärt man dem Modell, worauf es achten soll.
Einsatzfelder und Aufwand
| Einsatzfeld | Was das Modell übernimmt | Aufwand |
|---|---|---|
| Dokumente | Rechnungen, Lieferscheine, Formulare und Anhänge lesen und Daten strukturiert übergeben | mittel: Formatvielfalt, Prüfung gegen Stammdaten |
| Schadensprüfung | Fotos von Paketen, Fahrzeugen oder Waren auf sichtbare Schäden prüfen und dokumentieren | niedrig bis mittel: klare Kriterien, Beispielbilder |
| Anzeigen ablesen | Zählerstände, Displays oder Etiketten aus Fotos auslesen | mittel: Fehlerquote muss gegen echte Fotos gemessen werden |
| Verpackung und Montage | prüfen, ob alle Teile vorhanden und richtig platziert sind, und Hinweise geben | mittel: Schritt-für-Schritt-Anweisungen, Tests je Variante |
| Industrielle Prüfung | feine Defekte an Oberflächen oder Bauteilen erkennen | hoch: oft nur ergänzend zu spezialisierten Modellen |
Aus der Praxis: Radaway
Beim Hersteller von Badausstattung kommen Aufträge als E-Mail, oft mit Bestellungen im Anhang. Nach unserer Weiterentwicklung verarbeitet das System auch Aufträge in Anhängen, die Abdeckung stieg dort von 0 auf 100 %, und die manuellen Eingriffe sanken insgesamt um 90 %.
Beispiel: Zählerstände aus Fotos ablesen
In einem Test von 2024 fotografierte eine Kamera mehrmals täglich einen Wasserzähler. Ein rotes Rechteck markierte das Zählwerk, und das Modell sollte den Wert in einem festen Format zurückgeben, damit er direkt weiterverarbeitet werden kann.
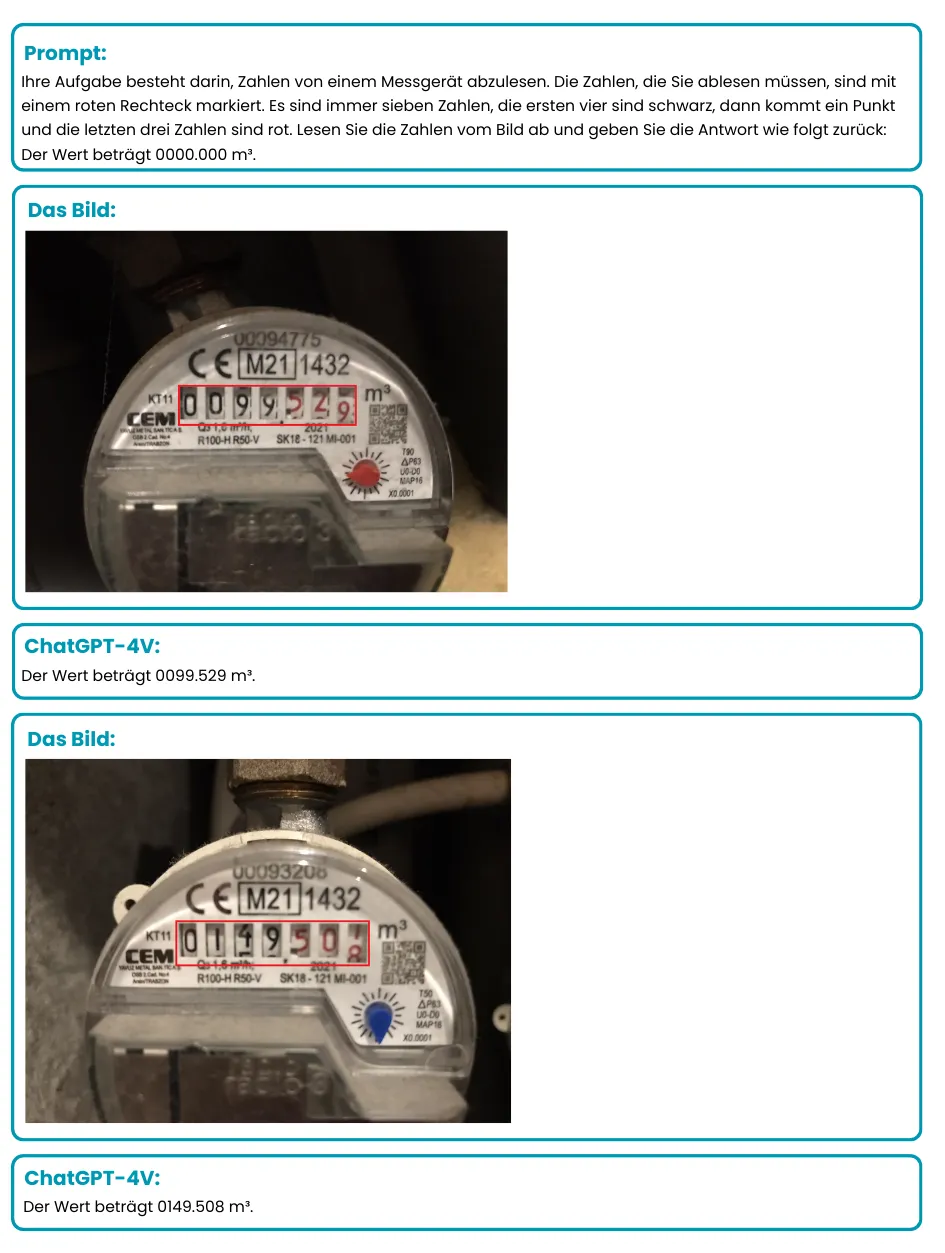
Das Beispiel zeigt, worauf es ankommt: eine eindeutige Anweisung, ein festes Ausgabeformat und eine Vorbereitung des Bildes, hier der markierte Bereich.
Was eine gute Anweisung ausmacht
- Klar und schrittweise: genau beschreiben, was das Modell im Bild tun soll, in der richtigen Reihenfolge.
- Kontext geben: worum es geht, welche Varianten vorkommen, welche Fehler typisch sind.
- Festes Format: eine Antwortstruktur vorgeben, wenn das Ergebnis weiterverarbeitet wird.
- Beispiele zeigen: bei feinen Unterschieden ein oder mehrere Beispielbilder mitgeben.
- Unsicherheit zulassen: dem Modell erlauben, „nicht erkennbar“ zu antworten, statt zu raten.
Wo die Grenzen liegen
In unseren Tests von 2024 zeigten sich drei typische Schwächen. Modelle haben sich seitdem verbessert, geprüft werden sollten diese Punkte trotzdem in jedem Projekt:
- Zählen: Viele gleichartige Objekte zuverlässig zu zählen, gelang oft nur mit sehr spezifischen Anweisungen.
- Genaue Positionen: Modelle nennen eher „unten links“ als exakte Koordinaten. Für präzise Lage braucht es klassische Computer Vision.
- Texterkennung: Einzelne Zeichen wurden ergänzt oder ausgelassen. Wo jede Ziffer zählt, braucht es Plausibilitätsprüfungen.
In der industriellen Defekterkennung sind spezialisierte Verfahren oft noch genauer. Unser Test dazu kommt zum Schluss: Ergänzung, noch kein Ersatz. Mehr im Beitrag LLMs in der visuellen Inspektion und Qualitätskontrolle.
So gehen Sie vor
- Aufgabe und Kriterien festlegen: Was soll auf Bild oder Dokument erkannt werden, und was gilt als korrekt?
- Prototyp mit einem multimodalen Modell: in wenigen Tagen zeigen, ob die Aufgabe grundsätzlich lösbar ist.
- An echten Daten messen: Fehlerquote auf einer repräsentativen Auswahl eigener Bilder oder Dokumente bestimmen.
- Entscheiden: multimodales Modell, spezialisiertes Modell oder beides kombiniert.
- Einbinden und überwachen: Ergebnisse in die bestehenden Systeme übergeben und im Betrieb laufend prüfen.
Wie Modelle systematisch verglichen werden, beschreibt unser Beitrag LLMOps für Unternehmen: Bewertung und Vergleich von Vision-LLMs.

Bilder und Dokumente automatisch auswerten?
Wir testen mit Ihnen auf eigenen Daten, ob ein multimodales Modell Ihre Aufgabe zuverlässig löst, und planen den Weg in den Betrieb.
Prozessanalyse anfragenHäufige Fragen
KI-Modelle, die mehrere Datenarten wie Text, Bilder und oft auch Audio gemeinsam verarbeiten. Sie können zum Beispiel ein Foto zusammen mit einer Anweisung auswerten und in Text antworten.
Zum Beispiel für die Verarbeitung von Rechnungen, Lieferscheinen und Anhängen, die Prüfung von Fotos auf Schäden, das Ablesen von Zählern und Displays und die Kontrolle von Verpackung oder Montage.
Für den Einstieg meist nicht. Anforderungen lassen sich in Worten und mit wenigen Beispielbildern beschreiben. Für den Produktivbetrieb sollte die Qualität aber an einer repräsentativen Auswahl eigener Daten gemessen werden.
Bei theBlue.ai gibt es die Analyse zum Festpreis ab 3.000 €. Eine Umsetzung liegt typischerweise zwischen 25.000 und 100.000 €, die genaue Schätzung folgt am Ende der Analyse.
Aleksandra entwickelt seit 2021 bei theBlue.ai maßgeschneiderte KI-Lösungen mit Schwerpunkt auf agentischen Implementierungen und lokalen LLM-Deployments, die passgenau auf Unternehmensanforderungen zugeschnitten sind. Als AI Engineer hilft sie Organisationen dabei, ihre Prozesse mit produktionsreifen Systemen zu automatisieren, von On-Premise-Open-Source-Modellen bis hin zu RAG-basierten internen Wissensdatenbanken für regulierte Branchen, und erweitert ihr Wissen kontinuierlich in der sich rasant wandelnden Welt der Künstlichen Intelligenz.
In ihren Artikeln teilt sie praktische Erfahrungen aus realen Enterprise-KI-Projekten und zeigt: KI im Unternehmen einzuführen muss nicht kompliziert sein.