
Computer Vision · Qualitätskontrolle
LLMs in der visuellen Inspektion und Qualitätskontrolle
Können Sprachmodelle mit Bildverständnis Defekte zuverlässig erkennen? Wir haben GPT-4o und Gemini 2.0 Pro an Leiterplatten und an Bildern aus industriellen Inspektionen getestet. Bei wechselnden Bedingungen können sie helfen, die Zuverlässigkeit spezialisierter Verfahren erreichen sie nicht.
 Aleksandra Osztynowicz
Das Wichtigste in Kürze
- Bei Leiterplatten erreichte GPT-4o einen F1-Score von höchstens 0,68, klassische Anomalieerkennung kommt auf einen AU-PRC-Wert von 0,98.
- In der industriellen Inspektion lag die Genauigkeit bei der Frage „Defekt oder kein Defekt“ bei 0,73 für GPT-4o und 0,66 für Gemini.
- Über eine API dauert die Auswertung 1 bis 10 Sekunden pro Bild, für Echtzeitkontrolle ist das zu langsam.
- LLMs eignen sich als Ergänzung bei stark wechselnden Bedingungen. Menschliche Prüfung bleibt nötig.
Können LLMs mit spezialisierten Verfahren mithalten?
Große Sprachmodelle (Large Language Models, LLMs) entwickeln sich schnell und eröffnen neue Möglichkeiten für die visuelle Inspektion. Bei Bilddaten spricht man genauer von Large Multimodal Models (LMMs), weil sie neben Sprache auch Bilder oder Audio verarbeiten. Wir bleiben hier beim geläufigeren Begriff LLM.
Viele Unternehmen möchten LLMs für ihre eigene Qualitätskontrolle testen. Die zentrale Frage lautet: Kommen sie an Verfahren heran, die speziell für diese Aufgabe entwickelt wurden? Um das herauszufinden, haben wir zwei Experimente unter realen Bedingungen durchgeführt. Im ersten ging es um Defekte auf Leiterplatten, im zweiten um industrielle Inspektionen, bei denen Bedingungen und Defekte stark schwanken.
Die Tests stammen vom März 2025 und nutzen die damals führenden Modelle. Neuere Modelle können anders abschneiden, die Methodik lässt sich übertragen.
Test 1: Defekterkennung auf Leiterplatten
Grundlage war der VisA-Datensatz (PCB4) aus AWS Open Data. Er ist anspruchsvoll: Es gibt wenige Defektbilder, die Klassen sind ungleich verteilt, und die Aufgabe ist eine Mehrklassen-Klassifikation. Manche Defektarten kommen häufig vor, andere fast gar nicht. Das macht es für jedes Modell schwer, über alle Defekte hinweg zu verallgemeinern.
GPT-4o bekam jeweils ein Bild und eine Beschreibung der möglichen Defektarten. Das Modell sollte den Defekt benennen oder bestätigen, dass die Platine fehlerfrei ist.
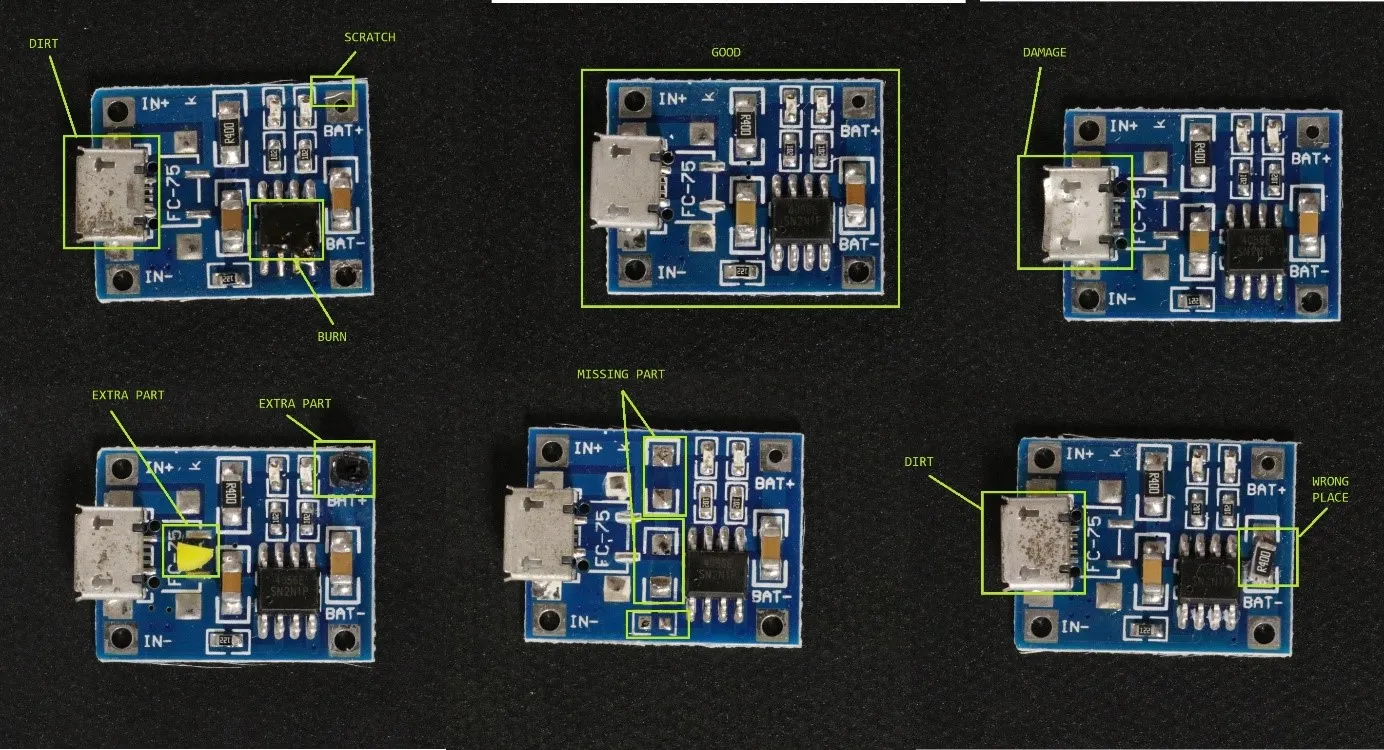
Wir haben 40 Bilder in zwei Szenarien getestet: nur mit defekten Bildern und gemischt mit fehlerfreien. Beim One-Shot-Learning sah das Modell vor dem Test ein Referenzbild mit möglichen Defekten.
| F1-Score | Ohne Beispiel | Mit One-Shot |
|---|---|---|
| Nur defekte Bilder | 0,37 | 0,51 |
| Defekt und fehlerfrei | 0,59 | 0,68 |
Der F1-Score misst, wie gut ein Modell bei ungleich verteilten Klassen arbeitet, je näher an 1, desto besser. Einige Defekte erkannte GPT-4o zuverlässig, andere gar nicht. Die bessere Bewertung im gemischten Szenario kam vor allem daher, dass fehlerfreie Platinen richtig eingeordnet wurden. Klassische Verfahren der Anomalieerkennung erreichten in früheren Studien einen vergleichbaren AU-PRC-Wert von 0,98.
Quelle: Zou, Jeong, Pemula, Zhang und Dabeer, SPot-the-Difference Self-Supervised Pre-training for Anomaly Detection and Segmentation, arXiv 2022
Test 2: Defekterkennung in der industriellen Inspektion
Leiterplatten werden meist unter kontrollierten Bedingungen geprüft. In industriellen Inspektionen wechseln Beleuchtung, Lage der Objekte und Bildauflösung dagegen stark. Für den zweiten Test nutzten wir deshalb Bilder und Videos aus dem Datensatz eines Kunden. Hinzu kamen ähnlich aussehende Defektarten, mehrere Labels pro Bild und eine lückenhafte Beschriftung.
Getestet haben wir ChatGPT-4o und Gemini-2.0-pro-exp-02-05, zu diesem Zeitpunkt die Spitzenreiter der Chatbot Arena für visuelle Aufgaben. Im ersten Ansatz sollten die Modelle den wahrscheinlichsten und den zweitwahrscheinlichsten Defekt nennen. One-Shot-Beispiele verbesserten die Vorhersagen, eine manuelle Prüfung durch Menschen machten sie aber nicht überflüssig. Im zweiten Ansatz ging es nur noch um die Entscheidung „Defekt“ oder „kein Defekt“.
| Genauigkeit | Erster Test | Nur Defekt ja/nein |
|---|---|---|
| ChatGPT-4o | 0,61 | 0,73 |
| Gemini 2.0 Pro | 0,63 | 0,66 |
Die vereinfachte Frage brachte bessere Werte. Für ein produktionsreifes Alarmsystem reicht das nicht, denn industrielle Anlagen verlangen eine nahezu fehlerfreie Zuverlässigkeit.
Die größten Hürden im industriellen Einsatz
- Verarbeitungszeit: Über eine API wird jedes Bild einzeln verarbeitet. Je nach Anfrage und Zahl der One-Shot-Beispiele dauert das 1 bis 10 Sekunden pro Bild. Für Echtzeitkontrolle an schnellen Linien ist das zu langsam.
- Hardware und Skalierung: Kleinere, lokal betriebene Modelle wie Qwen oder Molmo machen unabhängiger von Cloud-APIs, verlangen aber deutliche Investitionen in Hardware. Mehrere Prüfstandorte auszustatten bringt zusätzlichen Aufwand für Logistik und Infrastruktur.
Warum auf das eigene Unternehmen zugeschnittene Modelle eine Option sind, beschreibt unser Artikel zu maßgeschneiderten LLMs.
Fazit: Ergänzung, noch kein Ersatz
LLMs werden besser, sind aber noch keine eigenständige Lösung für die industrielle Sichtprüfung. Sie können einzelne Aufgaben unterstützen und brauchen dabei menschliche Aufsicht und zusätzliche Infrastruktur. In kontrollierten Umgebungen sind spezialisierte Machine-Learning-Modelle weiterhin überlegen.
Anders sieht es abseits der Standardlinie aus. Wo Bedingungen schwanken, Bilder unterschiedlich ausfallen und Daten mobil erfasst werden, können LLMs ein nützliches Zusatzwerkzeug sein.
Welcher Weg im Einzelfall trägt, zeigt nur ein Test unter echten Bedingungen. Wir bewerten KI-Modelle auf Praxistauglichkeit, vergleichen LLM-basierte, klassische und hybride Ansätze und begleiten die Integration in bestehende Abläufe, damit die Lösung zuverlässig und skalierbar läuft.

KI in Ihrer Qualitätskontrolle?
Wir testen mit Ihren Bildern, ob ein LLM, ein klassisches Modell oder eine Kombination Ihre Defekte zuverlässig erkennt.
Test anfragenHäufige Fragen
Nein. LLMs können bei der Erkennung von Defekten und Anomalien helfen, erreichen aber noch nicht die Zuverlässigkeit spezialisierter Machine-Learning-Modelle oder regelbasierter Systeme. Das gilt besonders in der Industrie, wo gleichbleibende Ergebnisse entscheidend sind.
Die Verarbeitungszeit von 1 bis 10 Sekunden pro Bild über eine API, die Abhängigkeit von Cloud-Diensten, wechselnde Bildbedingungen und schwankende Ergebnisse, die eine Prüfung durch Menschen nötig machen.
Bei explorativen Analysen, unter stark wechselnden Bedingungen und wenn nur wenige gelabelte Daten vorliegen. In gut strukturierten Produktionsprozessen sind klassische Modelle genauer und zuverlässiger.
Mit strukturierten Experimenten an eigenen Bildern und einem Vergleich mit klassischen Verfahren. So zeigt sich, welcher Ansatz für die konkrete Anwendung zuverlässig genug ist.
Aleksandra entwickelt seit 2021 bei theBlue.ai maßgeschneiderte KI-Lösungen mit Schwerpunkt auf agentischen Implementierungen und lokalen LLM-Deployments, die passgenau auf Unternehmensanforderungen zugeschnitten sind. Als AI Engineer hilft sie Organisationen dabei, ihre Prozesse mit produktionsreifen Systemen zu automatisieren, von On-Premise-Open-Source-Modellen bis hin zu RAG-basierten internen Wissensdatenbanken für regulierte Branchen, und erweitert ihr Wissen kontinuierlich in der sich rasant wandelnden Welt der Künstlichen Intelligenz.
In ihren Artikeln teilt sie praktische Erfahrungen aus realen Enterprise-KI-Projekten und zeigt: KI im Unternehmen einzuführen muss nicht kompliziert sein.