
Computer vision · Kontrola jakości
LLM w inspekcji wizualnej i kontroli jakości
Czy modele językowe rozumiejące obrazy potrafią niezawodnie wykrywać wady? Przetestowaliśmy GPT-4o i Gemini 2.0 Pro na płytkach PCB i na obrazach z inspekcji przemysłowych. Mogą pomóc tam, gdzie warunki się zmieniają, ale nie osiągają niezawodności wyspecjalizowanych metod.
 Aleksandra Osztynowicz
Najważniejsze w skrócie
- Na płytkach PCB GPT-4o osiągnął wynik F1 najwyżej 0,68, podczas gdy tradycyjne wykrywanie anomalii uzyskuje AU PRC na poziomie 0,98.
- W inspekcji przemysłowej dokładność przy pytaniu „wada czy brak wady” wyniosła 0,73 dla GPT-4o i 0,66 dla Gemini.
- Przez API analiza trwa od 1 do 10 sekund na obraz, czyli za długo na kontrolę jakości w czasie rzeczywistym.
- Modele LLM sprawdzają się jako uzupełnienie tam, gdzie warunki mocno się zmieniają. Weryfikacja przez człowieka nadal jest konieczna.
Czy LLM dorównują wyspecjalizowanym metodom?
Duże modele językowe (LLM) szybko się rozwijają i otwierają nowe możliwości w kontroli wizualnej. W przypadku obrazów trafniejszym określeniem są duże modele multimodalne (LMM), bo oprócz języka przetwarzają także obraz czy dźwięk. W tym tekście pozostajemy jednak przy bardziej znanym terminie LLM.
Wiele firm chce sprawdzić LLM we własnej kontroli jakości. Kluczowe pytanie brzmi, czy mogą one dorównać metodom stworzonym specjalnie do tego zadania. Żeby to sprawdzić, przeprowadziliśmy dwa eksperymenty w rzeczywistych warunkach. Pierwszy dotyczył wad na płytkach PCB, drugi inspekcji przemysłowych, w których warunki i rodzaje wad bardzo się różnią.
Testy pochodzą z marca 2025 roku i wykorzystują najlepsze modele z tamtego okresu. Nowsze modele mogą wypadać inaczej, a metodykę można przenieść na kolejne testy.
Test 1: wykrywanie wad na płytkach PCB
Wykorzystaliśmy zbiór danych VisA (PCB4) z AWS Open Data. Jest wymagający: obrazów z wadami jest niewiele, klasy są niezrównoważone, a zadanie to klasyfikacja wieloetykietowa. Niektóre rodzaje wad występują często, inne prawie wcale, przez co każdemu modelowi trudno uogólnić wiedzę na wszystkie rodzaje wad.
GPT-4o otrzymywał obraz wraz z opisem możliwych rodzajów wad. Model miał wskazać wadę albo potwierdzić, że płytka jest wolna od wad.
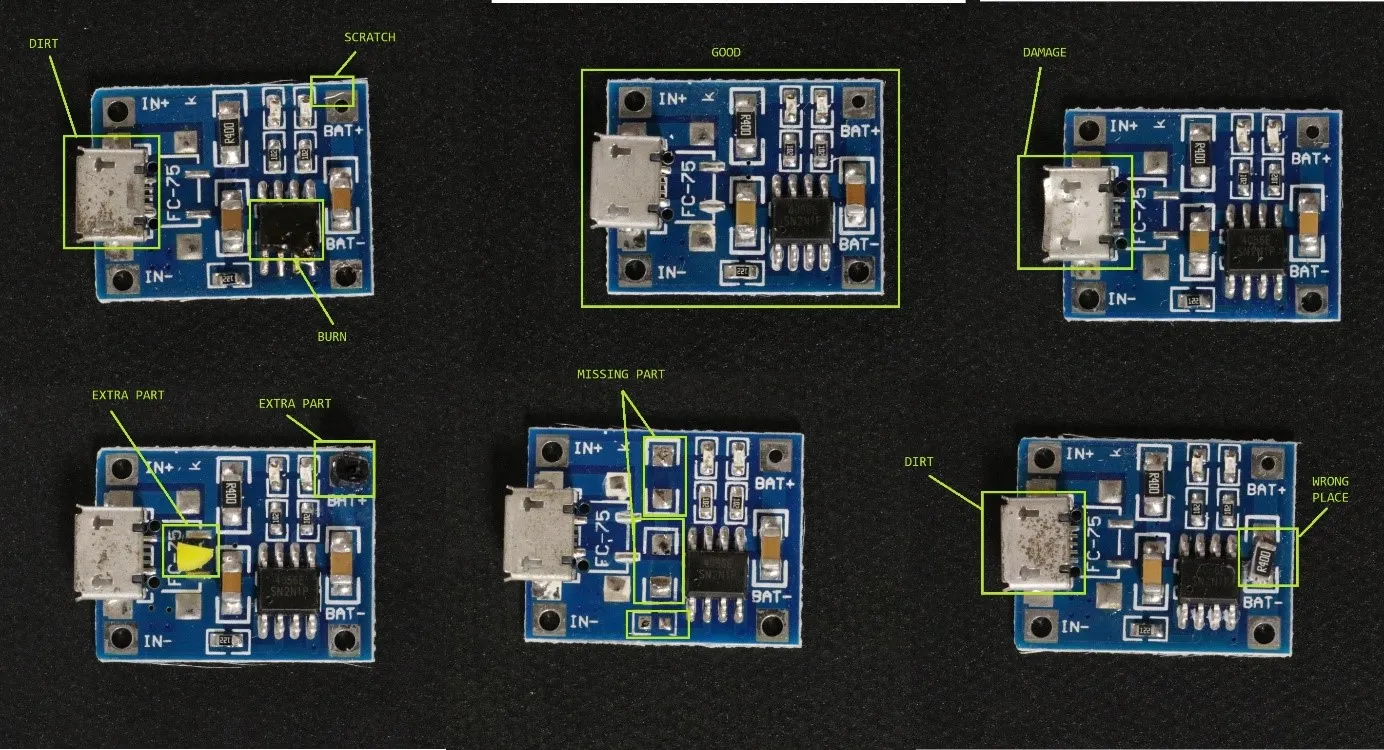
Przetestowaliśmy 40 obrazów w dwóch scenariuszach: tylko obrazy z wadami oraz zestaw mieszany z obrazami bez wad. W wariancie one-shot learning model przed testem widział obraz referencyjny z możliwymi wadami.
| Wynik F1 | Bez przykładu | One-shot |
|---|---|---|
| Tylko obrazy z wadami | 0,37 | 0,51 |
| Obrazy z wadami i bez wad | 0,59 | 0,68 |
Wynik F1 pokazuje, jak model radzi sobie z niezrównoważonymi klasami; im bliżej 1, tym lepiej. GPT-4o niektóre wady rozpoznawał niezawodnie, a inne całkowicie pomijał. Wyższy wynik w scenariuszu mieszanym wynikał głównie z poprawnie sklasyfikowanych płytek bez wad. Tradycyjne metody wykrywania anomalii osiągnęły we wcześniejszych badaniach porównywalny wskaźnik AU PRC na poziomie 0,98.
Źródło: Zou, Jeong, Pemula, Zhang i Dabeer, SPot-the-Difference Self-Supervised Pre-training for Anomaly Detection and Segmentation, arXiv 2022
Test 2: wykrywanie wad w inspekcji przemysłowej
Płytki PCB sprawdza się zwykle w kontrolowanych warunkach. W inspekcjach przemysłowych oświetlenie, położenie obiektów i rozdzielczość obrazów mocno się zmieniają. Dlatego w drugim teście wykorzystaliśmy zdjęcia i nagrania wideo ze zbioru danych klienta. Dodatkową trudność stanowiły wizualnie podobne rodzaje wad, kilka etykiet na jednym obrazie i skąpe oznaczenia.
Przetestowaliśmy ChatGPT-4o i Gemini-2.0-pro-exp-02-05, które prowadziły wtedy w rankingu Chatbot Arena w zadaniach wizyjnych. W pierwszym podejściu modele miały wskazać najbardziej prawdopodobną i drugą w kolejności wadę. Przykłady one-shot poprawiły trafność, ale nie wyeliminowały potrzeby ręcznej weryfikacji przez operatora. Drugie podejście sprowadzało zadanie do decyzji binarnej: wada albo brak wady.
| Dokładność | Pierwszy test | Wada tak/nie |
|---|---|---|
| ChatGPT-4o | 0,61 | 0,73 |
| Gemini 2.0 Pro | 0,63 | 0,66 |
Prostsze pytanie dało lepsze wyniki. Na potrzeby systemu alarmowego działającego na produkcji to nadal za mało, bo systemy przemysłowe wymagają niemal stuprocentowej niezawodności.
Główne przeszkody w zastosowaniach przemysłowych
- Czas przetwarzania: przez API każdy obraz jest przetwarzany osobno. W zależności od zapytania i liczby przykładów one-shot trwa to od 1 do 10 sekund na obraz. Na szybkich liniach produkcyjnych to za wolno na kontrolę jakości w czasie rzeczywistym.
- Sprzęt i skalowalność: mniejsze modele hostowane lokalnie, takie jak Qwen czy Molmo, zmniejszają zależność od chmurowych API, ale wymagają dużych inwestycji w sprzęt. Wyposażenie kilku stanowisk inspekcyjnych oznacza dodatkowy nakład logistyczny i infrastrukturalny.
W artykule o dedykowanych modelach LLM wyjaśniamy, dlaczego warto rozważyć modele dopasowane do konkretnej firmy.
Podsumowanie: na razie uzupełnienie, jeszcze nie zamiennik
Modele LLM stale się poprawiają, ale nie są jeszcze samodzielnym rozwiązaniem do przemysłowej kontroli wizualnej. Mogą wspierać pojedyncze zadania, ale potrzebują przy tym nadzoru człowieka i dodatkowej infrastruktury. W kontrolowanych warunkach przewagę nadal mają wyspecjalizowane modele uczenia maszynowego.
Inaczej wygląda to poza standardową linią produkcyjną. Tam, gdzie warunki są zmienne, obrazy się różnią, a dane rejestruje się urządzeniami mobilnymi, LLM mogą być przydatnym dodatkowym narzędziem.
Które podejście sprawdzi się w konkretnym przypadku, pokazuje dopiero test w rzeczywistych warunkach. Oceniamy modele AI pod kątem praktycznego zastosowania, porównujemy podejścia oparte na LLM, tradycyjne i hybrydowe oraz wspieramy integrację z istniejącymi procesami, żeby rozwiązanie działało niezawodnie i w dużej skali.

AI w Twojej kontroli jakości?
Na Twoich obrazach sprawdzamy, czy wady niezawodnie wykrywa LLM, tradycyjny model czy ich połączenie.
Zapytaj o testNajczęściej zadawane pytania
Nie. Mogą pomagać w wykrywaniu wad i anomalii, ale nie osiągają jeszcze niezawodności wyspecjalizowanych modeli uczenia maszynowego ani systemów opartych na regułach. Dotyczy to zwłaszcza przemysłu, gdzie powtarzalne wyniki mają kluczowe znaczenie.
Czas przetwarzania od 1 do 10 sekund na obraz przez API, zależność od usług chmurowych, zmienne warunki wykonywania zdjęć i niespójne wyniki, które wymagają weryfikacji przez człowieka.
W analizach eksploracyjnych, przy bardzo zmiennych warunkach i wtedy, gdy oznaczonych danych jest mało. W dobrze uporządkowanych procesach produkcyjnych tradycyjne modele są dokładniejsze i bardziej niezawodne.
Przez uporządkowane eksperymenty na własnych obrazach i porównanie z tradycyjnymi metodami. Dopiero wtedy widać, które podejście jest wystarczająco niezawodne w danym zastosowaniu.
Aleksandra od 2021 roku tworzy w theBlue.ai dedykowane rozwiązania AI. Specjalizuje się w systemach agentowych i wdrożeniach lokalnych modeli LLM dopasowanych do potrzeb firm. Jako AI Engineer pomaga organizacjom automatyzować procesy za pomocą systemów gotowych do pracy produkcyjnej: od modeli open source działających on-premise po wewnętrzne bazy wiedzy oparte na RAG dla branż regulowanych. Na bieżąco poszerza swoją wiedzę w szybko zmieniającym się świecie sztucznej inteligencji.
W swoich artykułach dzieli się doświadczeniem z prawdziwych projektów enterprise AI i pokazuje, że wdrożenie AI w firmie nie musi być skomplikowane.