
KI-Architektur & Integration · Evaluation
LLMOps für Unternehmen: Bewertung und Vergleich von Vision-LLMs
Welches Modell funktioniert für unseren Anwendungsfall am besten? Wer mit großen Sprachmodellen arbeitet, stellt diese Frage ständig neu, denn Modelle, Preise und Ergebnisse ändern sich laufend. Kommen Bilder als Eingabe dazu, wird es noch komplexer. LLMOps bringt Struktur in Vergleich, Bewertung und Betrieb.
 Aleksandra Osztynowicz
Das Wichtigste in Kürze
- LLMOps verwaltet den Einsatz vortrainierter Sprachmodelle: Prompts, Kontext, Bewertung und Überwachung im Betrieb.
- Bewertet wird selten gegen ein einziges richtiges Label. Relevanz, Kohärenz, Richtigkeit und Sicherheit brauchen Testsätze, menschliche Einschätzung oder LLM-as-a-Judge.
- Viele LLMOps-Tools sind auf Text ausgelegt. Für Vision-Modelle braucht es versionierte Bilddatensätze und angepasste Auswertungen.
- Langfuse und Phoenix eignen sich als Grundlage für reproduzierbare Vergleiche und lassen sich selbst betreiben.
Was LLMOps von MLOps unterscheidet
Klassisches MLOps dreht sich um das Training eigener Modelle mit klar definierten Datensätzen und bekannten richtigen Ergebnissen. Bei Anwendungen mit großen Sprachmodellen beginnt man meist mit einem vortrainierten Modell und passt es über Prompts, Kontext, Retrieval oder leichtes Fine-Tuning an. Die zentrale Frage lautet dann: Wie gewinnen wir daraus verlässlich nutzbare Ergebnisse?
| MLOps | LLMOps | |
|---|---|---|
| Ausgangspunkt | eigenes Modell trainieren | vortrainiertes Modell nutzen und anpassen |
| Stellschrauben | Trainingsdaten, Features, Hyperparameter | Prompts, Kontext, Retrieval, Modellwahl |
| Datensätze | Eingabe mit einem richtigen Ergebnis | realistische Anwendungsbeispiele, oft mit mehreren gültigen Antworten |
| Bewertung | Genauigkeit gegen Labels | Relevanz, Kohärenz, Richtigkeit, Sicherheit |
| Werkzeuge | Experiment-Tracking, Modellregister | Prompt-Versionierung, Tracing, Evaluation, Kostenüberwachung |
Mehr zum klassischen Ansatz lesen Sie in MLOps: KI-Modelle zuverlässig und skalierbar betreiben.
Prompts und Bewertung
Prompt Engineering ist ein laufender Prozess. Kleine Änderungen in der Formulierung können deutlich andere Ergebnisse liefern, und was letzte Woche funktioniert hat, kann nach einem Modell-Update oder bei leicht veränderten Eingaben nicht mehr greifen.
Auch die Bewertung ist anspruchsvoller. Gute Ausgaben sind relevant, zusammenhängend, inhaltlich richtig und sicher. Solche Kriterien lassen sich schwer in eine Zahl fassen und brauchen menschliche Einschätzung oder ein Modell, das Ausgaben nach festgelegten Kriterien bewertet (LLM-as-a-Judge). Ohne Versionierung von Prompts und direkten Vergleich der Ausgaben ist kaum zu erkennen, ob ein Team Fortschritte macht.
Die Datensätze dienen dabei meist der Bewertung. Sie bestehen aus realistischen Beispielen aus der tatsächlichen Nutzung, manchmal mit Beispielausgaben als Kontext oder mit ganzen Dialogverläufen.
Worauf LLMOps-Tools achten
- Prompt-Versionierung: Prompts verwalten, vergleichen und nachvollziehen.
- Monitoring: Tokenverbrauch, Latenz, Kosten und Fehlerraten überwachen.
- Tracing: mehrstufige Abläufe und Werkzeugaufrufe nachvollziehen.
- Evaluation: Ausgaben mit Testsätzen, LLM-as-a-Judge oder menschlicher Bewertung systematisch prüfen.
Diese Werkzeuge nutzen Entwickler ebenso wie Produktverantwortliche und Qualitätssicherung. Wie der Betrieb überwacht wird, beschreibt unser Beitrag Observability und Monitoring von LLMs.
Wenn Bilder dazukommen
Moderne multimodale Modelle verarbeiten neben Text auch Bilder. Das öffnet viele geschäftliche Anwendungen:
- Fehler in Produktbildern erkennen
- Mengen oder Kosten anhand von Fotos schätzen
- Arbeitsschritte anhand von Fotodokumentation prüfen
- Dokumente mit Texterkennung verarbeiten
- Räume für Navigationsaufgaben verstehen
Viele LLMOps-Tools sind jedoch auf Text optimiert. Für visuelle Workflows braucht es meist eine Kombination aus klassischen MLOps-Werkzeugen und angepassten Komponenten für Bewertung und Überwachung. Wie gut Vision-Modelle in der Qualitätsprüfung abschneiden, zeigt unser Beitrag LLMs in der visuellen Inspektion und Qualitätskontrolle.
Ein praxisnaher Workflow für Vision-LLMs
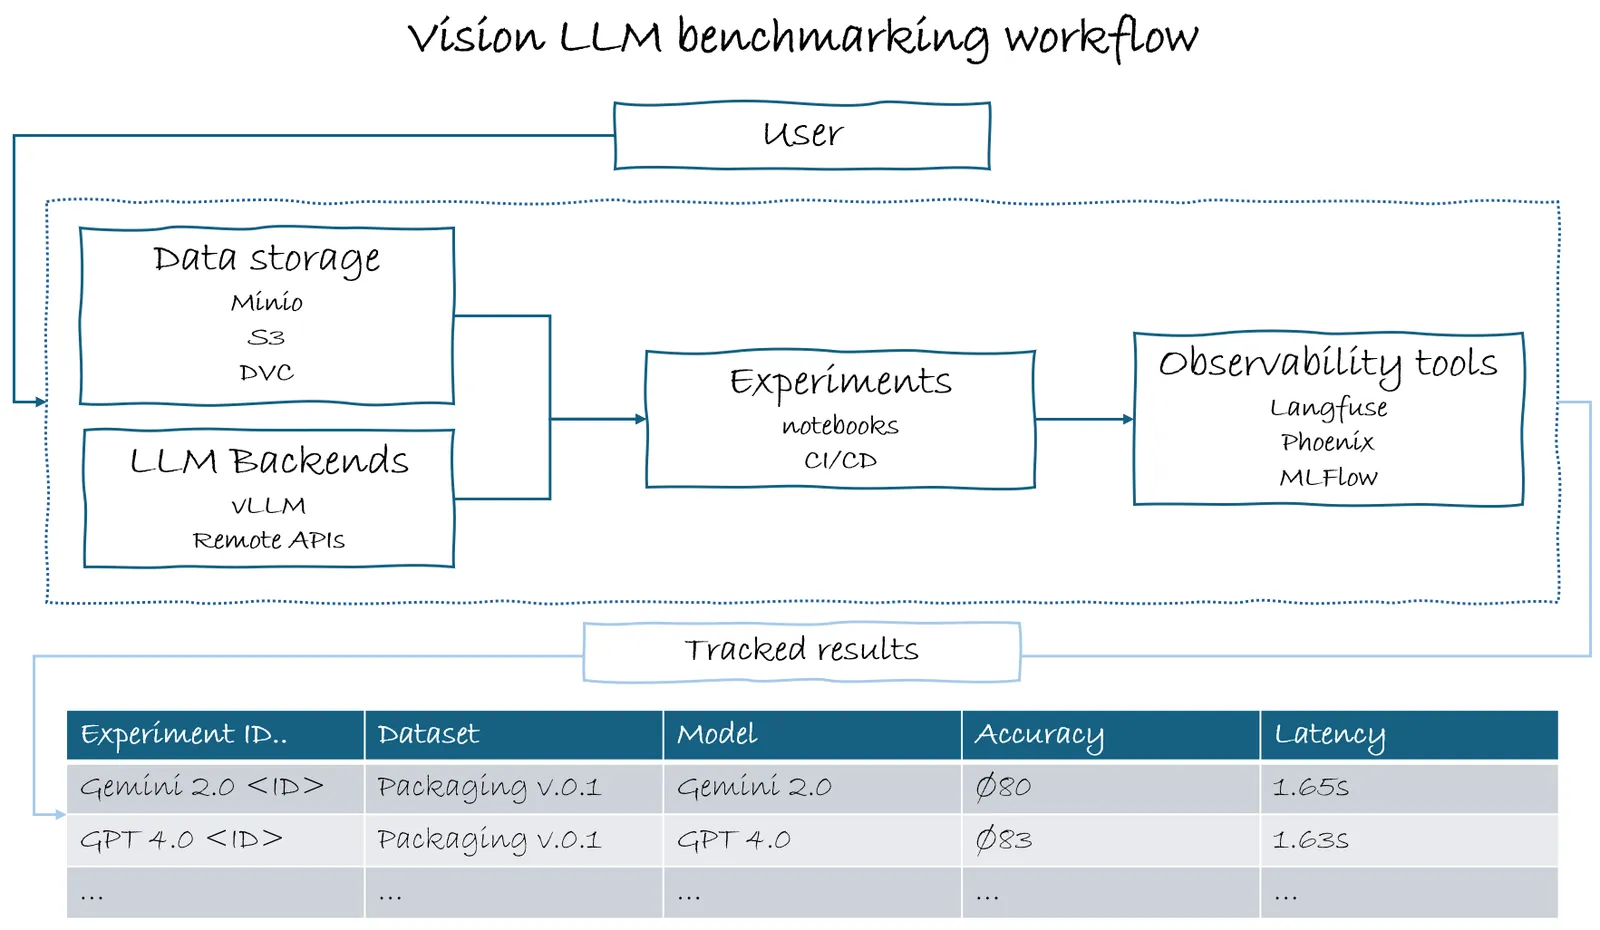
- Daten versionieren: Bilddatensätze in S3, MinIO oder DVC ablegen, mit Pfaden, Metadaten und Versionshistorie, damit Experimente vergleichbar bleiben.
- Modell-Backend wählen: selbst gehostet, etwa mit vLLM, oder über Cloud-APIs. Jede Variante hat eigene Vor- und Nachteile bei Latenz, Kosten und Kontrolle.
- Benchmarks ausführen: zuerst explorativ in Notebooks, später automatisiert in CI/CD-Pipelines, die bei Änderungen an Modell oder Datensatz starten.
- Metriken überwachen: Tokenverbrauch, Antwortzeiten und Fehlerraten, um Leistungsprobleme und Kosten früh zu erkennen.
- Tracing einsetzen: bei RAG oder Agenten, um Abläufe nachzuvollziehen und Fehlerquellen zu finden.
- Ausgaben bewerten: mit Scoring, manuellen Vergleichen oder LLM-as-a-Judge nach klar definierten Kriterien.
- Ergebnisse dokumentieren: Vergleiche, Prompt-Änderungen und Fortschritt über die Zeit sichtbar machen.
Beispielhafte Werkzeuge
- Langfuse unterstützt beim Verfolgen von Experimenten, bei der Versionierung von Prompts und bei Auswertungen der wichtigsten Kennzahlen. Es ist Open Source und lässt sich selbst betreiben.
- Phoenix von Arize verwaltet Datensätze und Experimente, visualisiert Auswertungen und bietet Tracing sowie Prompt-Verwaltung. Es steht unter der Elastic License 2.0 und lässt sich lokal, in Containern oder in der Cloud betreiben.
Beide lassen sich um eigene Logik für bildbasierte Workflows erweitern. Das erfordert etwas Konfiguration und schafft eine solide Grundlage für reproduzierbare Bewertungen.
So starten Sie
- Aufgabe und Kriterien festlegen: Was soll das Modell leisten, und woran erkennen Fachleute ein gutes Ergebnis?
- Testsatz aufbauen: realistische Beispiele, bei Vision-Aufgaben mit versionierten Bildern.
- Mehrere Modelle vergleichen: gleiche Daten, gleiche Kriterien, dokumentierte Prompts.
- Automatisieren: Vergleiche laufen bei jeder Änderung erneut, im Betrieb ergänzt um Monitoring.

Das passende Modell für Ihren Anwendungsfall finden?
Wir vergleichen mit Ihnen Modelle auf Ihren eigenen Daten und bauen einen Bewertungsprozess, der auch nach Modell-Updates trägt.
Prozessanalyse anfragenHäufige Fragen
Die Praxis, Anwendungen mit großen Sprachmodellen strukturiert zu entwickeln und zu betreiben: Prompts versionieren, Modelle vergleichen, Ausgaben bewerten und Kosten, Latenz und Fehler im Betrieb überwachen.
MLOps konzentriert sich auf das Training eigener Modelle mit gelabelten Daten. LLMOps arbeitet meist mit vortrainierten Modellen und steuert deren Ergebnisse über Prompts, Kontext und Retrieval, bewertet nach Kriterien wie Relevanz und Richtigkeit.
Mit versionierten Bilddatensätzen aus realistischen Beispielen, festen Bewertungskriterien, dem Vergleich mehrerer Modelle unter gleichen Bedingungen und automatisierten Benchmarks, die bei Änderungen erneut laufen.
Zum Beispiel Langfuse für Tracing, Prompt-Versionierung und Auswertungen sowie Phoenix von Arize für Datensätze, Experimente und Evaluation. Beide lassen sich selbst betreiben.
Aleksandra entwickelt seit 2021 bei theBlue.ai maßgeschneiderte KI-Lösungen mit Schwerpunkt auf agentischen Implementierungen und lokalen LLM-Deployments, die passgenau auf Unternehmensanforderungen zugeschnitten sind. Als AI Engineer hilft sie Organisationen dabei, ihre Prozesse mit produktionsreifen Systemen zu automatisieren, von On-Premise-Open-Source-Modellen bis hin zu RAG-basierten internen Wissensdatenbanken für regulierte Branchen, und erweitert ihr Wissen kontinuierlich in der sich rasant wandelnden Welt der Künstlichen Intelligenz.
In ihren Artikeln teilt sie praktische Erfahrungen aus realen Enterprise-KI-Projekten und zeigt: KI im Unternehmen einzuführen muss nicht kompliziert sein.