
Architektura i integracja AI · Ewaluacja
LLMOps w firmie: benchmarking i porównywanie modeli vision LLM
Który model najlepiej sprawdzi się w naszym zastosowaniu? To pytanie wraca raz po raz w pracy z dużymi modelami językowymi, bo modele, ceny i wyniki ciągle się zmieniają. Gdy na wejściu pojawiają się obrazy, sprawa komplikuje się jeszcze bardziej. LLMOps porządkuje porównywanie, ewaluację i utrzymanie modeli.
 Aleksandra Osztynowicz
Najważniejsze w skrócie
- LLMOps obejmuje pracę z pretrenowanymi modelami językowymi: prompty, kontekst, ewaluację i monitoring na produkcji.
- Ewaluacja rzadko polega na porównaniu z jedną poprawną etykietą. Trafność, spójność, poprawność i bezpieczeństwo wymagają zestawów testowych, oceny człowieka lub LLM-as-a-judge.
- Wiele narzędzi LLMOps powstało z myślą o tekście. Modele wizyjne wymagają wersjonowanych zbiorów obrazów i dostosowanej ewaluacji.
- Langfuse i Phoenix to dobra podstawa powtarzalnych porównań. Oba narzędzia można hostować samodzielnie.
Czym LLMOps różni się od MLOps
Klasyczne MLOps koncentruje się na trenowaniu własnych modeli na jasno zdefiniowanych zbiorach danych ze znanymi poprawnymi wynikami. W aplikacjach opartych na dużych modelach językowych zwykle zaczyna się od modelu pretrenowanego i dostosowuje go przez prompty, kontekst, wyszukiwanie w dokumentach (retrieval) albo lekki fine-tuning. Kluczowe pytanie brzmi więc: jak niezawodnie uzyskiwać z niego użyteczne wyniki?
| MLOps | LLMOps | |
|---|---|---|
| Punkt wyjścia | trenowanie własnego modelu | wykorzystanie i dostosowanie modelu pretrenowanego |
| Na co wpływamy | dane treningowe, cechy, hiperparametry | prompty, kontekst, retrieval, wybór modelu |
| Zbiory danych | dane wejściowe z jednym poprawnym wynikiem | realistyczne przypadki użycia, często z kilkoma poprawnymi odpowiedziami |
| Ewaluacja | dokładność względem etykiet | trafność, spójność, poprawność, bezpieczeństwo |
| Narzędzia | śledzenie eksperymentów, rejestr modeli | wersjonowanie promptów, tracing, ewaluacja, monitoring kosztów |
Więcej o klasycznym podejściu piszemy w artykule Niezawodne i skalowalne rozwiązania AI dzięki MLOps.
Prompty i ewaluacja
Prompt engineering to proces ciągły. Drobne zmiany w sformułowaniu mogą dać bardzo różne wyniki, a to, co działało tydzień temu, może przestać działać po aktualizacji modelu albo przy nieco innych danych wejściowych.
Trudniejsza jest też ewaluacja. Dobre odpowiedzi są trafne, spójne, zgodne z faktami i bezpieczne. Takich kryteriów nie da się łatwo zamknąć w jednej liczbie, dlatego potrzebna jest ocena człowieka albo model, który ocenia wyniki według zdefiniowanych kryteriów (LLM-as-a-judge). Bez wersjonowania promptów i bezpośredniego porównywania wyników trudno stwierdzić, czy zespół robi postępy.
Zbiory danych służą tu głównie do ewaluacji. Składają się z realistycznych przykładów, które odzwierciedlają rzeczywiste użycie, czasem z przykładowymi odpowiedziami jako kontekstem albo z pełną historią rozmowy.
Co obejmują narzędzia LLMOps
- Wersjonowanie promptów: zarządzanie promptami, ich porównywanie i śledzenie zmian.
- Monitoring: kontrola zużycia tokenów, opóźnień, kosztów i odsetka błędów.
- Tracing: śledzenie wieloetapowych przebiegów i wywołań narzędzi.
- Ewaluacja: systematyczna ocena wyników za pomocą zestawów testowych, LLM-as-a-judge albo przeglądu przez ludzi.
Z tych narzędzi korzystają zarówno deweloperzy, jak i product ownerzy oraz dział kontroli jakości. O monitorowaniu systemów na produkcji piszemy w artykule Obserwowalność i monitorowanie LLM.
Gdy na wejściu pojawiają się obrazy
Nowoczesne modele multimodalne przetwarzają nie tylko tekst, ale i obrazy. To otwiera wiele zastosowań biznesowych:
- wykrywanie wad na zdjęciach produktów
- szacowanie ilości lub kosztów na podstawie zdjęć
- weryfikacja etapów pracy na podstawie dokumentacji fotograficznej
- przetwarzanie dokumentów z rozpoznawaniem tekstu
- rozumienie przestrzeni na potrzeby nawigacji
Wiele narzędzi LLMOps jest jednak zoptymalizowanych pod tekst. Procesy wizyjne zwykle wymagają połączenia klasycznych narzędzi MLOps z dostosowanymi komponentami do ewaluacji i monitoringu. Jak modele wizyjne radzą sobie w kontroli jakości, pokazujemy w artykule Modele LLM w kontroli wizualnej i kontroli jakości.
Praktyczny proces pracy z modelami vision LLM
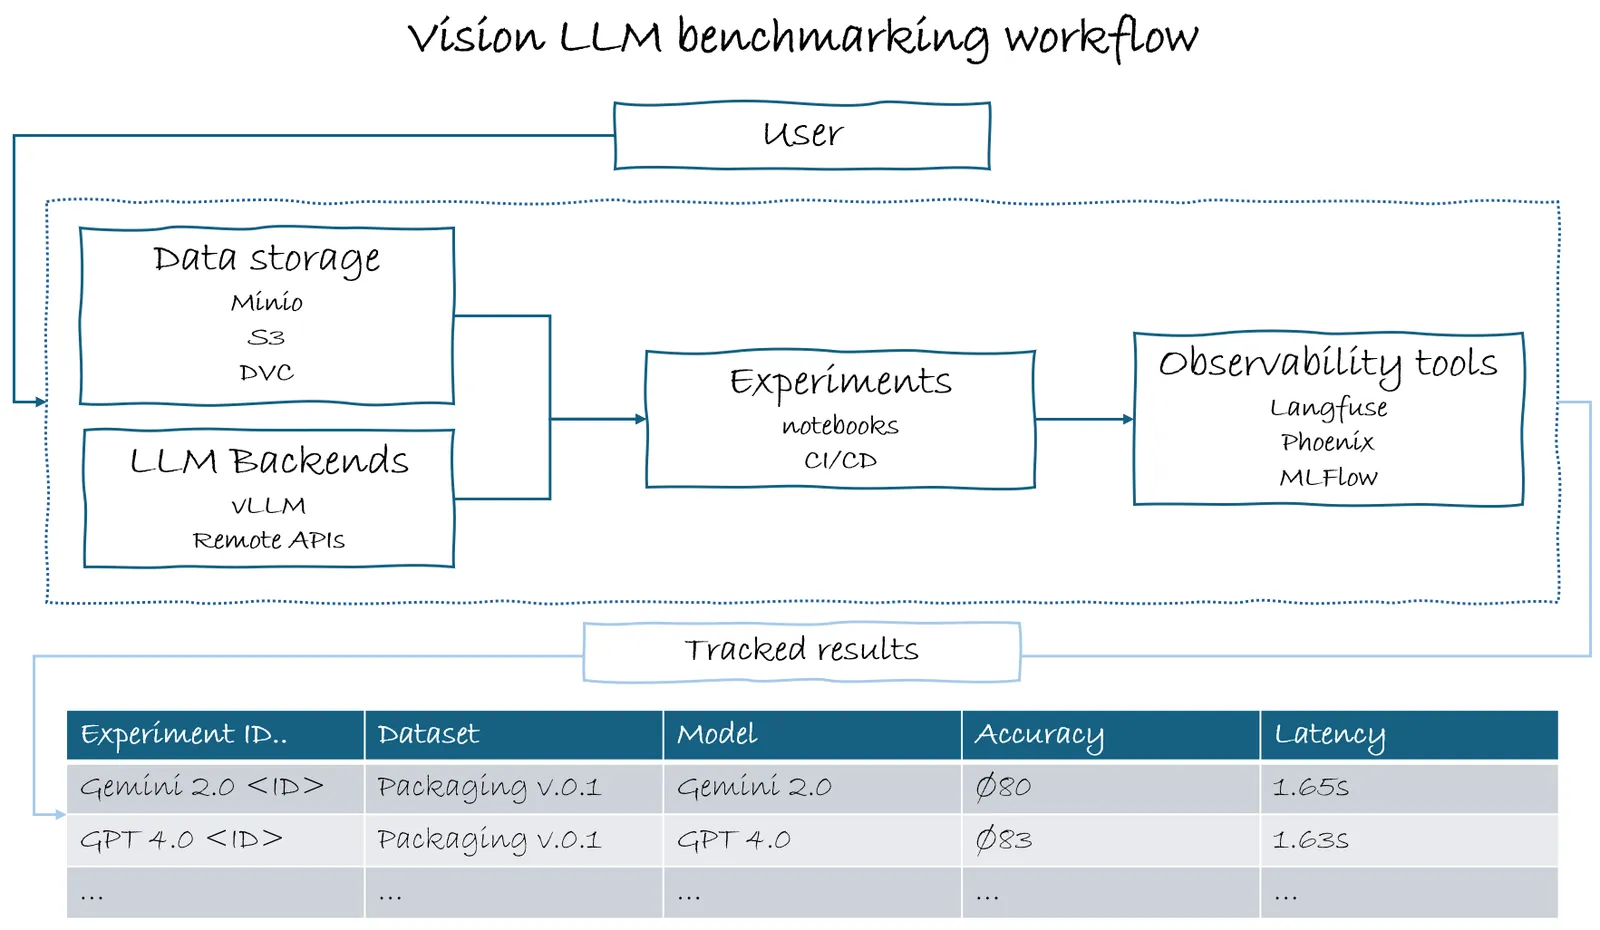
- Wersjonuj dane: przechowuj zbiory obrazów w S3, MinIO lub DVC ze ścieżkami, metadanymi i historią wersji, aby eksperymenty dało się ze sobą porównywać.
- Wybierz backend modelu: hostowany samodzielnie, np. z vLLM, albo przez API w chmurze. Każda opcja ma inne zalety i wady pod względem opóźnień, kosztów i kontroli.
- Uruchamiaj benchmarki: najpierw eksploracyjnie w notebookach, później automatycznie w pipeline’ach CI/CD, uruchamianych przy każdej zmianie modelu lub zbioru danych.
- Monitoruj metryki: zużycie tokenów, czasy odpowiedzi i odsetek błędów, aby wcześnie wychwycić problemy z wydajnością i kosztami.
- Korzystaj z tracingu: przy RAG lub agentach, aby śledzić przebiegi i znajdować źródła błędów.
- Oceniaj wyniki: przez punktację, ręczne porównanie albo LLM-as-a-judge według jasno określonych kryteriów.
- Dokumentuj wyniki: tak, aby porównania, zmiany promptów i postępy w czasie były widoczne.
Przykładowe narzędzia
- Langfuse wspiera śledzenie eksperymentów, wersjonowanie promptów i raporty z kluczowymi metrykami. Jest open source i można go hostować samodzielnie.
- Phoenix firmy Arize zarządza zbiorami danych i eksperymentami, wizualizuje ewaluacje oraz oferuje tracing i zarządzanie promptami. Udostępniany jest na licencji Elastic License 2.0 i może działać lokalnie, w kontenerach albo w chmurze.
Oba narzędzia można rozszerzyć o własną logikę dla procesów opartych na obrazach. Wymaga to pewnej konfiguracji, ale daje solidną podstawę do powtarzalnej ewaluacji.
Jak zacząć
- Określ zadanie i kryteria: co model ma robić i po czym eksperci poznają dobry wynik?
- Zbuduj zestaw testowy: realistyczne przykłady, a przy zadaniach wizyjnych wersjonowane obrazy.
- Porównaj kilka modeli: te same dane, te same kryteria, udokumentowane prompty.
- Zautomatyzuj: porównania uruchamiają się ponownie przy każdej zmianie, a na produkcji uzupełnia je monitoring.

Szukasz modelu dopasowanego do swojego zastosowania?
Razem z Tobą porównujemy modele na Twoich danych i budujemy proces ewaluacji, który sprawdza się także po aktualizacjach modeli.
Zapytaj o analizę procesuNajczęściej zadawane pytania
To uporządkowany sposób tworzenia i utrzymywania aplikacji opartych na dużych modelach językowych: wersjonowanie promptów, porównywanie modeli, ocena wyników oraz monitorowanie kosztów, opóźnień i błędów na produkcji.
MLOps koncentruje się na trenowaniu własnych modeli na oznaczonych danych. LLMOps pracuje głównie z modelami pretrenowanymi i steruje ich wynikami przez prompty, kontekst i retrieval, a ocenia je według kryteriów takich jak trafność i poprawność.
Na wersjonowanych zbiorach obrazów z realistycznymi przykładami, według stałych kryteriów oceny, porównując kilka modeli w tych samych warunkach i z pomocą automatycznych benchmarków, które uruchamiają się ponownie przy każdej zmianie.
Na przykład Langfuse do tracingu, wersjonowania promptów i raportów oraz Phoenix firmy Arize do zbiorów danych, eksperymentów i ewaluacji. Oba narzędzia można hostować samodzielnie.
Aleksandra od 2021 roku tworzy w theBlue.ai dedykowane rozwiązania AI. Specjalizuje się w systemach agentowych i wdrożeniach lokalnych modeli LLM dopasowanych do potrzeb firm. Jako AI Engineer pomaga organizacjom automatyzować procesy za pomocą systemów gotowych do pracy produkcyjnej: od modeli open source działających on-premise po wewnętrzne bazy wiedzy oparte na RAG dla branż regulowanych. Na bieżąco poszerza swoją wiedzę w szybko zmieniającym się świecie sztucznej inteligencji.
W swoich artykułach dzieli się doświadczeniem z prawdziwych projektów enterprise AI i pokazuje, że wdrożenie AI w firmie nie musi być skomplikowane.