
Computer vision · Obraz i tekst
Multimodalna AI w firmie: obrazy, dokumenty i tekst w jednym systemie
Wiele procesów w firmie nie ogranicza się do tekstu: zdjęcia szkód, zeskanowane dowody dostawy, odczyty liczników, etykiety, formularze. Modele multimodalne rozumieją jednocześnie obraz i tekst, więc mogą przejąć takie zadania bez dużych zbiorów danych treningowych. Oto przegląd tego, gdzie to już dziś działa, a gdzie jeszcze nie.
 Aleksandra Osztynowicz
Najważniejsze w skrócie
- Modele multimodalne przetwarzają w jednym modelu tekst, obrazy, a często także dźwięk, i odpowiadają na pytania o to, co widzą.
- Typowe zastosowania to przetwarzanie dokumentów, sprawdzanie zdjęć, odczytywanie wyświetlaczy oraz kontrola opakowań i montażu.
- Największa zaleta: wymagania można opisać słowami, a prototyp powstaje bez tysięcy oznaczonych przykładów.
- Przed wdrożeniem produkcyjnym trzeba przetestować model na własnych danych. W kontroli jakości w przemyśle wyspecjalizowane metody są często nadal dokładniejsze.
Czym są modele multimodalne
Klasyczne sieci neuronowe specjalizują się w jednym rodzaju danych, np. w obrazach albo w tekście. Modele multimodalne łączą kilka rodzajów danych w jednym systemie: patrzą na zdjęcie, czytają dołączone polecenie i odpowiadają tekstem. Dzięki temu da się wykonać zadania, które wcześniej wymagały kilku osobnych modeli, np. opisać obraz, odpowiedzieć na pytania o niego albo zrozumieć tekst w dokumencie w jego kontekście.
Dla firm nowe jest przede wszystkim to, że wymagania można po prostu opisać. Zamiast oznaczać tysiące przykładów „poprawnie zmontowanego” produktu, wyjaśniasz modelowi, na co ma zwracać uwagę.
Zastosowania i nakład pracy
| Zastosowanie | Co przejmuje model | Nakład pracy |
|---|---|---|
| Dokumenty | odczytywanie faktur, dowodów dostawy, formularzy i załączników oraz przekazywanie danych w uporządkowanej formie | średni: różnorodność formatów, porównanie z danymi podstawowymi |
| Kontrola uszkodzeń | sprawdzanie zdjęć paczek, pojazdów lub towarów pod kątem widocznych uszkodzeń i ich dokumentowanie | niski do średniego: jasne kryteria, przykładowe zdjęcia |
| Odczyt wyświetlaczy | odczytywanie stanów liczników, wyświetlaczy lub etykiet ze zdjęć | średni: odsetek błędów trzeba zmierzyć na prawdziwych zdjęciach |
| Opakowania i montaż | sprawdzanie, czy wszystkie części są na miejscu i prawidłowo ułożone, oraz podpowiadanie kolejnych kroków | średni: instrukcje krok po kroku, testy dla każdego wariantu |
| Kontrola jakości w przemyśle | wykrywanie drobnych wad na powierzchniach lub elementach | wysoki: często tylko w połączeniu z modelami wyspecjalizowanymi |
W praktyce: Radaway
U producenta wyposażenia łazienek zamówienia przychodzą e-mailem, często z zamówieniem w załączniku. Po naszych usprawnieniach system obsługuje także zamówienia w załącznikach: pokrycie tego typu zamówień wzrosło z 0 do 100%, a liczba ręcznych interwencji spadła łącznie o 90%.
Przykład: odczyt stanu licznika ze zdjęć
W teście z 2024 roku kamera kilka razy dziennie fotografowała wodomierz. Czerwony prostokąt oznaczał liczydło, a model miał zwrócić wartość w ustalonym formacie, tak aby można ją było od razu przetwarzać dalej.
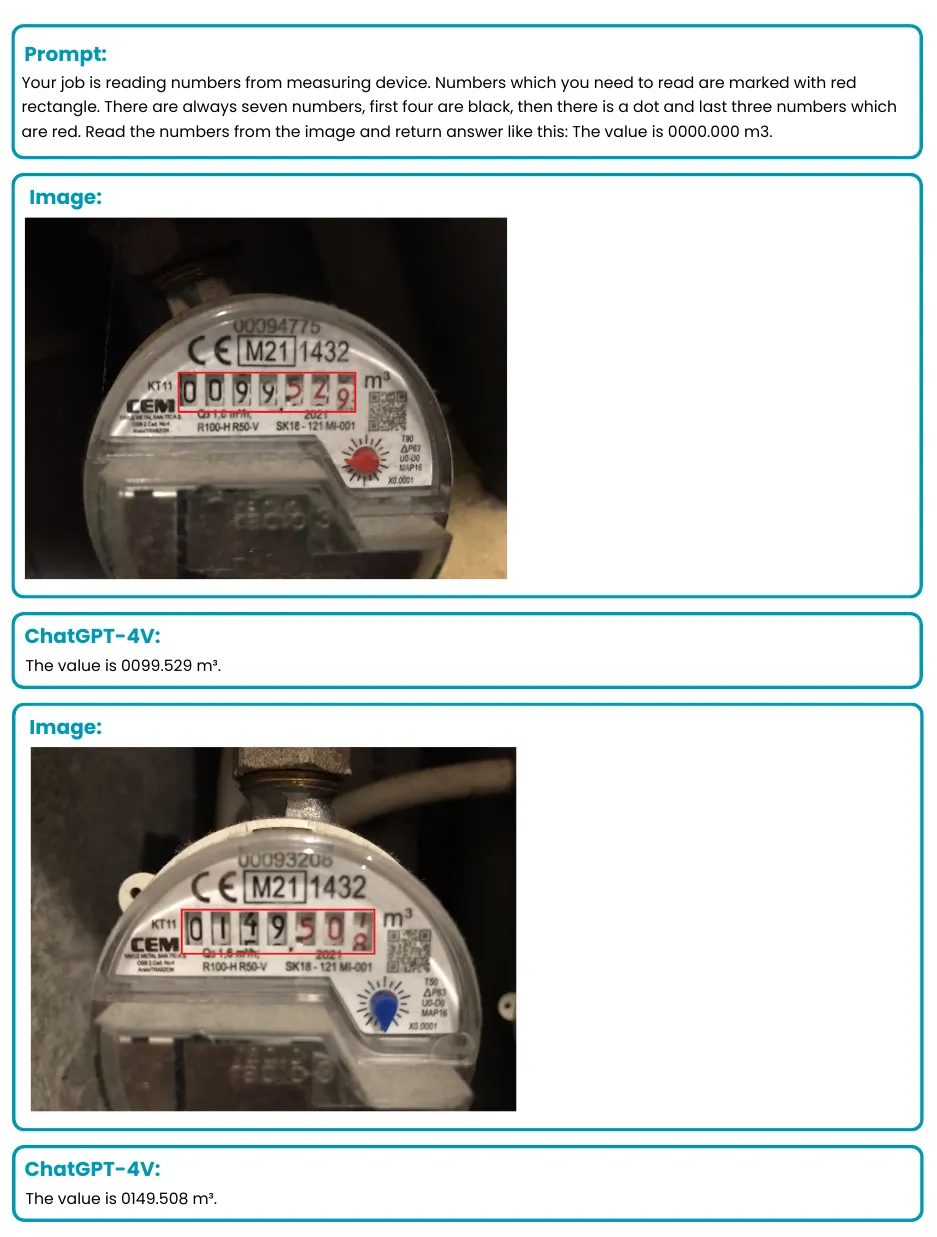
Przykład pokazuje, co jest ważne: jasne polecenie, ustalony format odpowiedzi i przygotowany obraz, w tym przypadku z zaznaczonym obszarem.
Jak napisać dobre polecenie
- Jasno i krok po kroku: opisz dokładnie, co model ma zrobić z obrazem, we właściwej kolejności.
- Podaj kontekst: czego dotyczy zadanie, jakie warianty się zdarzają, jakie błędy są typowe.
- Ustalony format: określ strukturę odpowiedzi, jeśli wynik ma być dalej przetwarzany.
- Pokaż przykłady: przy subtelnych różnicach dołącz jedno lub kilka przykładowych zdjęć.
- Dopuść niepewność: pozwól modelowi odpowiedzieć „nieczytelne”, zamiast zgadywać.
Gdzie są granice
Nasze testy z 2024 roku pokazały trzy typowe słabości. Modele od tego czasu się poprawiły, ale te punkty nadal warto sprawdzać w każdym projekcie:
- Liczenie: wiarygodne policzenie wielu podobnych obiektów często udawało się tylko przy bardzo szczegółowych poleceniach.
- Dokładne położenie: modele chętniej piszą „na dole po lewej”, niż podają dokładne współrzędne. Do precyzyjnej lokalizacji potrzebne jest klasyczne computer vision.
- Rozpoznawanie tekstu: pojedyncze znaki bywały dodawane lub pomijane. Tam, gdzie liczy się każda cyfra, potrzebne są kontrole wiarygodności.
W wykrywaniu wad w przemyśle wyspecjalizowane metody są często nadal dokładniejsze. Nasz test w tym obszarze kończy się wnioskiem, że modele multimodalne na razie je uzupełniają i jeszcze ich nie zastępują. Więcej w artykule LLM w kontroli wizualnej i kontroli jakości.
Jak się do tego zabrać
- Określ zadanie i kryteria: co ma zostać rozpoznane na obrazie lub w dokumencie i co uznajemy za poprawny wynik?
- Prototyp z modelem multimodalnym: w ciągu kilku dni sprawdź, czy zadanie w ogóle da się rozwiązać.
- Pomiar na prawdziwych danych: ustal odsetek błędów na reprezentatywnej próbce własnych zdjęć lub dokumentów.
- Decyzja: model multimodalny, model wyspecjalizowany albo ich połączenie.
- Integracja i monitorowanie: przekazuj wyniki do istniejących systemów i stale sprawdzaj je na produkcji.
Jak systematycznie porównywać modele, opisujemy w artykule LLMOps w firmie: benchmarki i porównanie modeli vision LLM.

Automatyczna ocena zdjęć i dokumentów?
Na Twoich danych sprawdzamy, czy model multimodalny niezawodnie rozwiązuje Twoje zadanie, i planujemy drogę do wdrożenia produkcyjnego.
Zapytaj o analizę procesuNajczęściej zadawane pytania
To modele AI, które przetwarzają jednocześnie kilka rodzajów danych, takich jak tekst, obrazy, a często także dźwięk. Mogą np. ocenić zdjęcie na podstawie dołączonego polecenia i odpowiedzieć tekstem.
Na przykład do przetwarzania faktur, dowodów dostawy i załączników, sprawdzania zdjęć pod kątem uszkodzeń, odczytywania liczników i wyświetlaczy oraz kontroli opakowań i montażu.
Na początek zwykle nie. Wymagania można opisać słowami i kilkoma przykładowymi zdjęciami. Przed wdrożeniem produkcyjnym jakość trzeba zmierzyć na reprezentatywnej próbce własnych danych.
W theBlue.ai analiza ma stałą cenę od 3000 €. Wdrożenie kosztuje zwykle od 25 000 do 100 000 €, a na koniec analizy otrzymujesz wycenę dla określonego zakresu.
Aleksandra od 2021 roku tworzy w theBlue.ai dedykowane rozwiązania AI. Specjalizuje się w systemach agentowych i wdrożeniach lokalnych modeli LLM dopasowanych do potrzeb firm. Jako AI Engineer pomaga organizacjom automatyzować procesy za pomocą systemów gotowych do pracy produkcyjnej: od modeli open source działających on-premise po wewnętrzne bazy wiedzy oparte na RAG dla branż regulowanych. Na bieżąco poszerza swoją wiedzę w szybko zmieniającym się świecie sztucznej inteligencji.
W swoich artykułach dzieli się doświadczeniem z prawdziwych projektów enterprise AI i pokazuje, że wdrożenie AI w firmie nie musi być skomplikowane.