
LLMs & KI-Agenten · RAG in der MedTech
Wie RAG Sicherheitsfragebögen in der MedTech-Branche automatisiert
Krankenhäuser verlangen von MedTech-Anbietern umfangreiche Sicherheitsfragebögen, bevor sie deren Produkte einsetzen. Bei apoQlar kostete jeder davon rund einen Monat und acht bis zehn Beteiligte. Ein Assistent auf Basis von Retrieval-Augmented Generation beantwortet die Fragen heute aus geprüften Dokumenten, mit Quelle.
 Aleksandra Osztynowicz
Das Wichtigste in Kürze
- Retrieval-Augmented Generation verbindet Sprachmodelle mit Unternehmensdokumenten und liefert überprüfbare Antworten mit Quelle.
- Bei apoQlar sank die Bearbeitungszeit von Sicherheitsfragebögen um 75 %, von rund einem Monat auf unter eine Woche.
- Die Einführung neuer Krankenhauskunden verkürzte sich von sechs auf zwei Wochen, statt acht bis zehn Beteiligten prüft ein kleines Team.
- Erfolgsfaktoren sind gute Datenqualität, ein klar definierter Anwendungsfall, frühes Prototyping und laufendes Monitoring.
Retrieval-Augmented Generation (RAG) verbindet die Sprachfähigkeit großer Sprachmodelle mit den Daten und Dokumenten eines Unternehmens. Das Ergebnis sind KI-Systeme, die präzise, aktuelle und überprüfbare Informationen aus internen Quellen liefern. Gerade in regulierten Branchen wie der Medizintechnik, wo Sicherheits- und Compliance-Dokumentation effizient, fehlerfrei und nachvollziehbar sein muss, macht das einen großen Unterschied.
Die Herausforderung: Sicherheitsfragebögen vor jedem Krankenhausprojekt
Das MedTech-Unternehmen apoQlar aus Hamburg entwickelt Mixed-Reality- und KI-Lösungen, die holografische Bildgebung in den Operationssaal bringen. Bevor ein Krankenhaus eine solche Plattform einführt, verlangt es einen ausgefüllten Sicherheitsfragebogen. Diese Fragebögen prüfen Datenschutz, IT-Sicherheit, regulatorische Compliance und technische Integration und enthalten Dutzende bis Hunderte Fragen, etwa zu Verschlüsselung, Zugriffskontrollen, Vorfallmanagement oder Softwarearchitektur.
Für apoQlar bedeutete das erheblichen Aufwand. Ein einzelner Fragebogen dauerte rund einen Monat und band acht bis zehn Personen aus IT, Qualitätssicherung, Compliance und Recht, obwohl die Antworten längst in internen Dokumenten standen. Jede Frage musste mit Handbüchern, Sicherheitsrichtlinien und technischer Dokumentation abgeglichen werden. Die Folge waren hohe Personalkosten, lange Durchlaufzeiten und Verzögerungen bei der Einführung in Krankenhäusern.
Die Lösung: ein KI-Assistent auf Basis von RAG
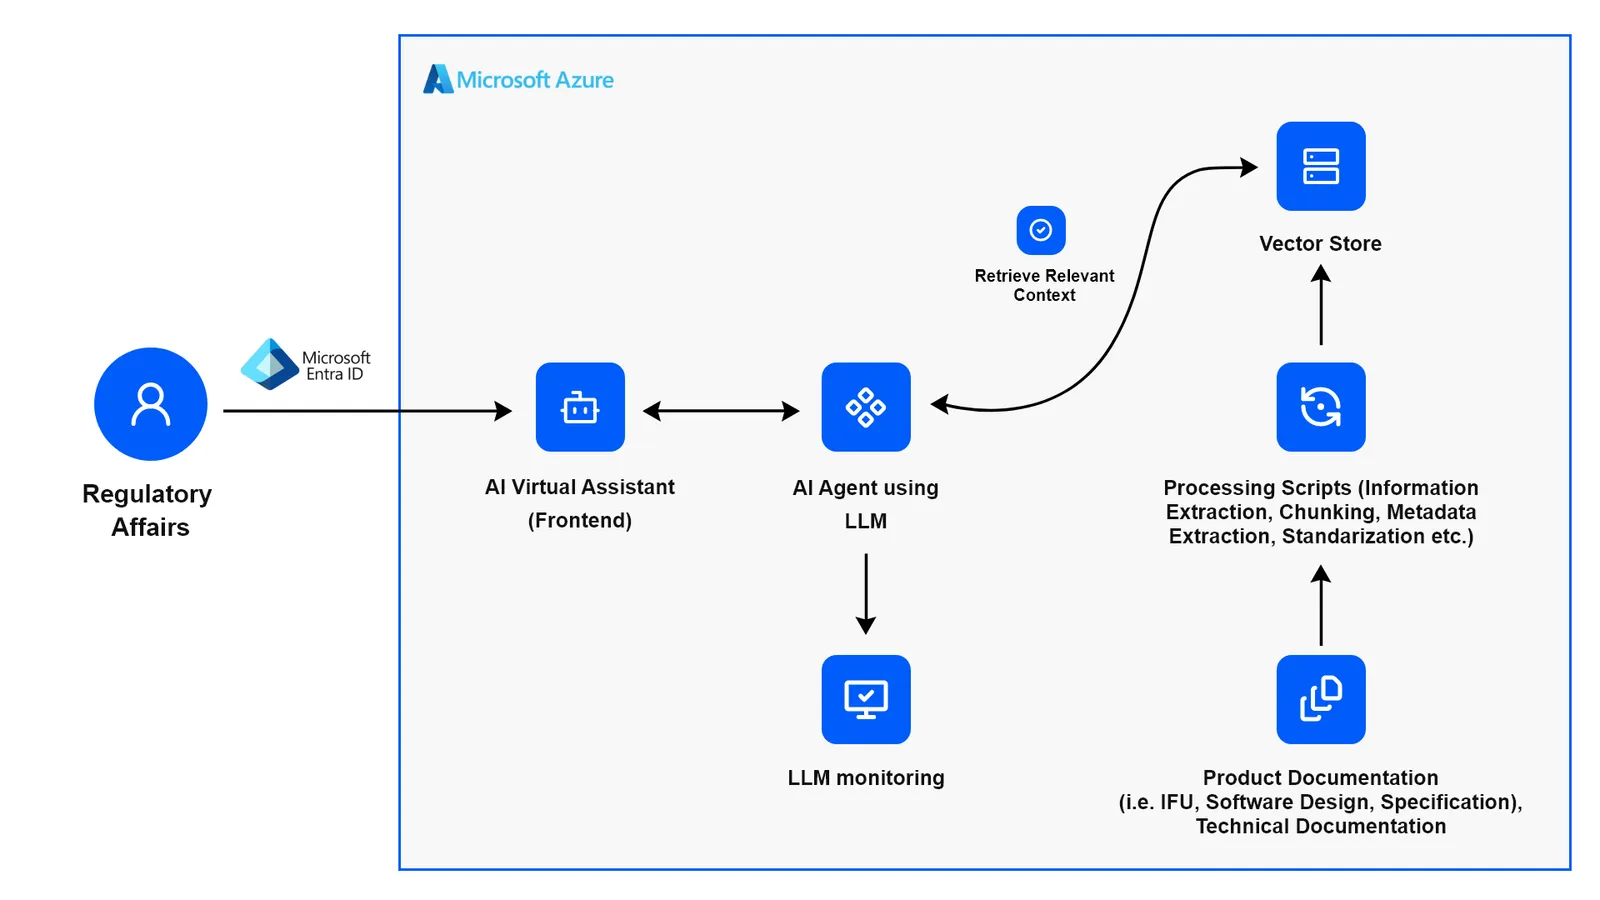
Gemeinsam mit apoQlar haben wir einen Assistenten entwickelt, der die Antworten aus allen relevanten Unternehmensquellen abruft und formuliert. Richtlinien und technische Dokumentation, die zuvor als PDF-Dateien und Confluence-Einträge verteilt lagen, wurden in einem zentralen Wissensspeicher zusammengeführt.
Darauf baut „Zippy“ auf, ein Assistent mit Azure OpenAI Services als Sprachmodell, ChromaDB als Vektordatenbank und einer sicheren Azure-Infrastruktur. Diese Kombination sichert Skalierbarkeit, Datenschutz und Nachvollziehbarkeit, zentrale Anforderungen für KI in regulierten Branchen. Zippy nennt bei jeder Antwort die exakte Quelle mit Dokumentname und Seitenzahl.
Die Lösung ist eine Webanwendung mit Chat-Oberfläche. Sie beantwortet gezielt technische oder regulatorische Fragen wie „Wie werden Datenverschlüsselung und Zugriffskontrolle in der Cloud umgesetzt?“ oder „Welche Prozesse sichern die Datenintegrität bei der Bildverarbeitung?“. Alle Antworten stützen sich ausschließlich auf geprüfte Unternehmensdokumente.
Ergebnisse: schneller, genauer, früher beim Kunden
Aus der Praxis: apoQlar
75 % kürzere Bearbeitungszeit
, von rund einem Monat auf unter eine Woche. Statt acht bis zehn Beteiligten prüft heute ein kleines Team die vorformulierten Antworten. Bei rund 15 Fragebögen im Jahr liegt die geschätzte Ersparnis bei etwa 90.000 US-Dollar, und die Einführung neuer Krankenhauskunden verkürzte sich von sechs auf zwei Wochen.
Weil Zippy nur auf aktuelle, geprüfte Dokumente zugreift, sind die Antworten konsistenter und Fehlerquellen seltener. Über eine Rückmeldefunktion können Mitarbeitende fehlerhafte oder veraltete Inhalte direkt markieren, so bleibt die Wissensbasis aktuell.
Was ist Retrieval-Augmented Generation?
RAG reichert große Sprachmodelle mit externen Wissensquellen an und arbeitet in zwei Schritten:
- Retrieval: Das System durchsucht eine Datenbank oder Dokumentensammlung nach Informationen zur gestellten Frage.
- Generation: Das Sprachmodell formuliert auf dieser Grundlage eine fundierte, kontextbezogene Antwort.
Weil das Wissen im Moment der Frage abgerufen wird, lässt es sich jederzeit aktualisieren, ohne das Modell neu zu trainieren.
RAG oder Fine-Tuning?
Ein Sprachmodell lässt sich auch durch Fine-Tuning an eine Fachdomäne anpassen, also durch Weitertrainieren mit eigenen Daten. Das ist aufwendiger und muss bei geänderten Inhalten wiederholt werden. RAG ergänzt dagegen jede Anfrage um passende Informationen, ähnlich wie ein Mensch vor der Antwort kurz in der richtigen Datei nachschlägt.
| RAG | Fine-Tuning | |
|---|---|---|
| Wissen aktualisieren | Dokumente austauschen, sofort wirksam | erneutes Training nötig |
| Quellenangabe | jede Antwort mit Dokument und Seite | nicht vorgesehen |
| Aufwand | mittel | hoch |
| Passt, wenn | sich Wissen oft ändert und Belege gebraucht werden | Vokabular oder Ausgabestil sehr speziell sind |
Für Sicherheitsfragebögen, deren Antworten belegbar sein müssen und deren Grundlagen sich ändern, ist RAG deshalb die passende Wahl. Beide Ansätze lassen sich auch kombinieren. Mehr zur Einordnung in unserem Artikel Maßgeschneiderte LLMs.
Wie wir RAG-Systeme aufbauen
Wir entwickeln skalierbare, produktionsreife RAG-Architekturen, zugeschnitten auf die Anforderungen des jeweiligen Unternehmens:
- modulare Bausteine für Datenaufbereitung, Embedding, Vektorsuche und LLM-Orchestrierung,
- Betrieb in der Cloud, hybrid oder On-Premise,
- Monitoring und Evaluation von Antwortqualität, Kontextrelevanz und Datensicherheit,
- Anbindung an bestehende Systeme wie SharePoint, Salesforce, Confluence, ERP-Plattformen oder Eigenentwicklungen.
So gelangen Unternehmen in wenigen Wochen vom Konzept zu einer produktiv nutzbaren Anwendung. Mehr dazu auf unserer Seite zur RAG-Entwicklung.
Herausforderungen und Erfolgsfaktoren
Der Aufbau einer leistungsfähigen RAG-Lösung ist anspruchsvoll, aber planbar. Häufige Herausforderungen sind hohe Anforderungen an Datenqualität und Struktur, die Auswahl und Skalierung der Vektordatenbank, Datenschutz und Governance sowie die Integration in bestehende Systeme und Abläufe.
Erfolgreich sind Projekte mit einem klar definierten Anwendungsfall und Ziel, einem iterativen Vorgehen mit frühem Prototyp, dem passenden Sprachmodell und Framework und kontinuierlichem Monitoring. Worauf es beim Aufbau im Detail ankommt, beschreibt unser Artikel Zuverlässige RAG-Systeme.

Dokumentation und Compliance mit RAG beschleunigen?
Wir prüfen mit Ihnen, welche Fragebögen, Audits oder Nachweise sich aus Ihren Dokumenten beantworten lassen und wie ein Prototyp mit echten Daten aussieht.
Prozessanalyse anfragenHäufige Fragen
Ein RAG-Assistent sucht zu jeder Frage die passenden Stellen in Richtlinien und technischer Dokumentation und formuliert daraus eine Antwort mit Dokumentname und Seite. Fachleute prüfen die Antworten, statt sie selbst zusammenzutragen.
Bei apoQlar sank die Bearbeitungszeit um 75 %, von rund einem Monat auf unter eine Woche. Die Einführung neuer Krankenhauskunden verkürzte sich von sechs auf zwei Wochen.
Azure OpenAI Services als Sprachmodell, ChromaDB als Vektordatenbank und eine gesicherte Azure-Infrastruktur, mit Anmeldung über Microsoft Entra ID und LLM-Monitoring.
Für Wissen, das sich ändert und belegt werden muss, meist ja, weil Dokumente ohne neues Training aktualisiert werden können und jede Antwort eine Quelle hat. Fine-Tuning lohnt sich bei sehr speziellem Vokabular oder festem Ausgabestil, beide Ansätze lassen sich kombinieren.
Aleksandra entwickelt seit 2021 bei theBlue.ai maßgeschneiderte KI-Lösungen mit Schwerpunkt auf agentischen Implementierungen und lokalen LLM-Deployments, die passgenau auf Unternehmensanforderungen zugeschnitten sind. Als AI Engineer hilft sie Organisationen dabei, ihre Prozesse mit produktionsreifen Systemen zu automatisieren, von On-Premise-Open-Source-Modellen bis hin zu RAG-basierten internen Wissensdatenbanken für regulierte Branchen, und erweitert ihr Wissen kontinuierlich in der sich rasant wandelnden Welt der Künstlichen Intelligenz.
In ihren Artikeln teilt sie praktische Erfahrungen aus realen Enterprise-KI-Projekten und zeigt: KI im Unternehmen einzuführen muss nicht kompliziert sein.