
LLM i agenci AI · RAG w MedTech
Jak RAG automatyzuje kwestionariusze bezpieczeństwa i compliance w MedTech
Szpitale wymagają od dostawców technologii medycznych wypełnienia obszernych kwestionariuszy bezpieczeństwa, zanim zaczną korzystać z ich produktów. W apoQlar każdy taki kwestionariusz zajmował około miesiąca i angażował od ośmiu do dziesięciu osób. Dziś na pytania odpowiada asystent oparty na RAG (retrieval-augmented generation), który korzysta ze zweryfikowanych dokumentów i podaje źródła.
 Aleksandra Osztynowicz
Najważniejsze w skrócie
- RAG (retrieval-augmented generation) łączy modele językowe z dokumentami firmy i daje odpowiedzi, które można sprawdzić, bo zawierają źródła.
- W apoQlar czas obsługi kwestionariuszy bezpieczeństwa skrócił się o 75%, z około miesiąca do niecałego tygodnia.
- Wdrożenie nowych klientów szpitalnych trwa dwa tygodnie zamiast sześciu, a odpowiedzi sprawdza mały zespół zamiast ośmiu do dziesięciu osób.
- O sukcesie decydują dobra jakość danych, jasno określone zastosowanie, wczesny prototyp i stały monitoring.
RAG (retrieval-augmented generation) łączy możliwości dużych modeli językowych z danymi i dokumentami firmy. Powstają w ten sposób systemy AI, które dostarczają precyzyjnych, aktualnych i możliwych do sprawdzenia informacji z wewnętrznych źródeł. W branżach regulowanych, takich jak technologia medyczna, gdzie dokumentacja bezpieczeństwa i compliance musi powstawać sprawnie, być rzetelna i dawać się prześledzić, ma to ogromne znaczenie.
Wyzwanie: kwestionariusz bezpieczeństwa przed każdym projektem w szpitalu
Firma apoQlar z Hamburga rozwija rozwiązania mixed reality i AI, które wprowadzają obrazowanie holograficzne na salę operacyjną. Zanim szpital wdroży taką platformę, wymaga wypełnionego kwestionariusza bezpieczeństwa. Kwestionariusze te oceniają ochronę danych, bezpieczeństwo IT, zgodność z regulacjami i integrację techniczną, a liczą od kilkudziesięciu do kilkuset pytań, m.in. o szyfrowanie, kontrolę dostępu, zarządzanie incydentami czy architekturę oprogramowania.
Dla apoQlar oznaczało to spory nakład pracy. Jeden kwestionariusz zajmował około miesiąca i angażował od ośmiu do dziesięciu osób z działów IT, zapewnienia jakości, compliance i prawnego, choć odpowiedzi znajdowały się już w wewnętrznych dokumentach. Każde pytanie trzeba było sprawdzić w podręcznikach, politykach bezpieczeństwa i dokumentacji technicznej. Skutkiem były wysokie koszty osobowe, długi czas realizacji i opóźnienia we wdrożeniach w szpitalach.
Rozwiązanie: asystent AI oparty na RAG
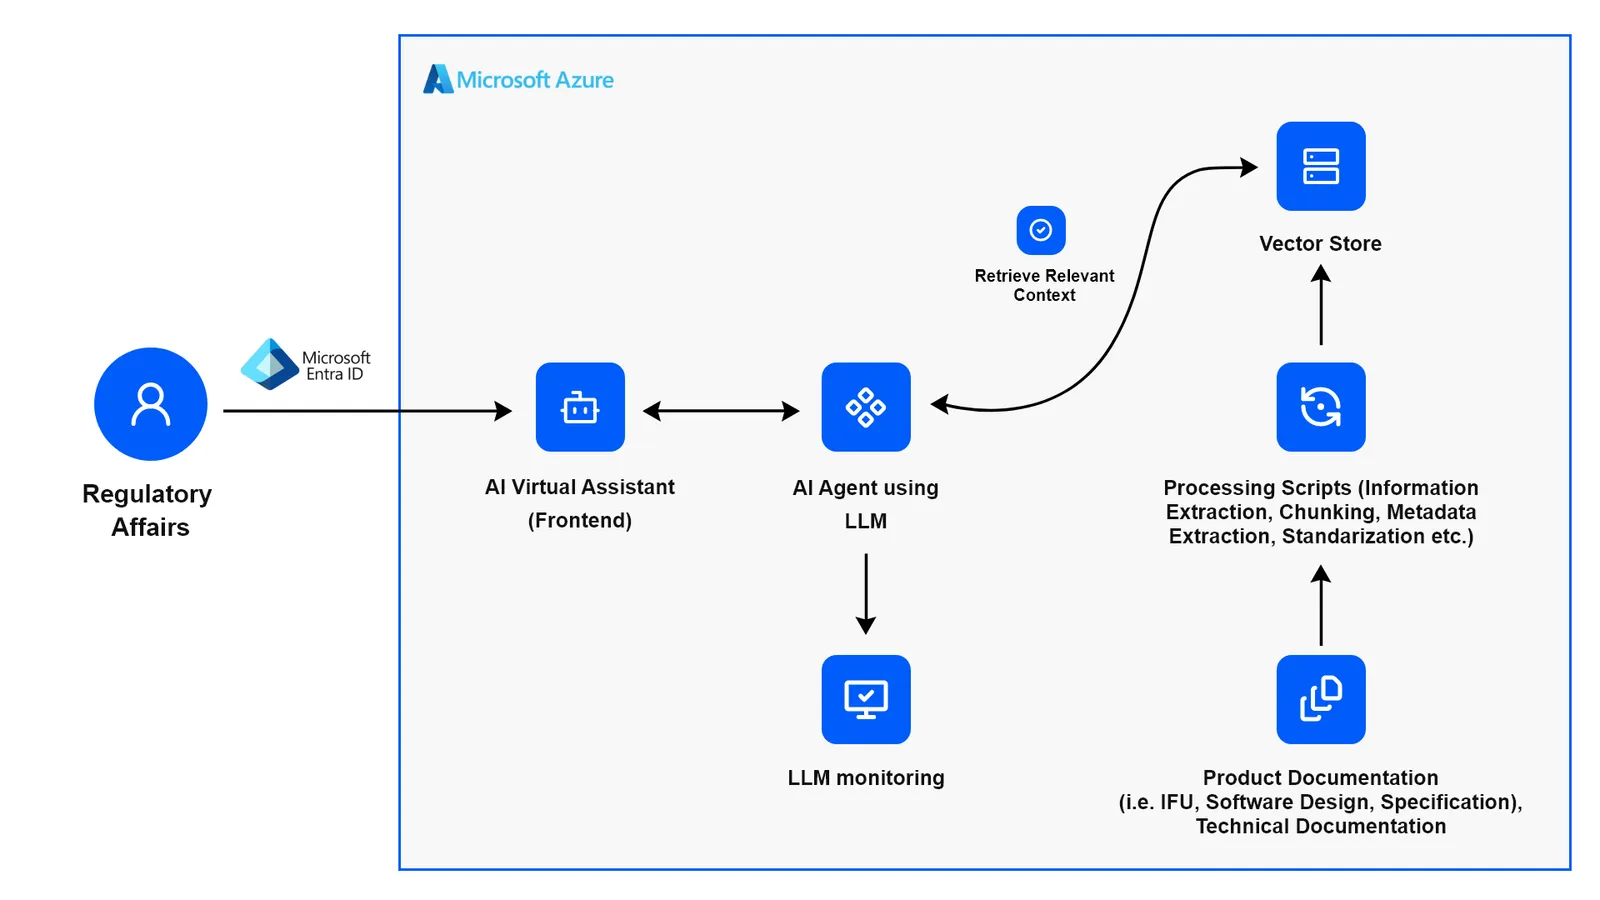
Razem z apoQlar zbudowaliśmy asystenta, który wyszukuje informacje we wszystkich istotnych źródłach firmy i przygotowuje na ich podstawie projekty odpowiedzi. Polityki i dokumentacja techniczna, wcześniej rozproszone w plikach PDF i na stronach Confluence, zostały zebrane w jednym centralnym repozytorium wiedzy.
Na tym repozytorium działa „Zippy”: asystent, w którym modelem językowym jest Azure OpenAI Services, a bazą wektorową ChromaDB. Całość działa w zabezpieczonej infrastrukturze Azure. Takie połączenie zapewnia skalowalność, ochronę danych i identyfikowalność, czyli podstawowe wymagania wobec AI w branżach regulowanych. Przy każdej odpowiedzi Zippy podaje dokładne źródło, łącznie z nazwą dokumentu i numerem strony.
Rozwiązanie to aplikacja webowa z interfejsem czatu. Odpowiada na konkretne pytania techniczne lub regulacyjne, na przykład „Jak w chmurze zrealizowano szyfrowanie danych i kontrolę dostępu?” albo „Jakie procesy zapewniają integralność danych podczas przetwarzania obrazów?”. Wszystkie odpowiedzi opierają się wyłącznie na zweryfikowanych dokumentach firmy.
Wyniki: szybciej, dokładniej i wcześniej u klienta
Z praktyki: apoQlar
Czas obsługi krótszy o 75%
, z około miesiąca do niecałego tygodnia. Zamiast ośmiu do dziesięciu osób przygotowane odpowiedzi sprawdza teraz mały zespół. Przy około 15 kwestionariuszach rocznie szacowane oszczędności wynoszą około 90 000 USD, a wdrożenie nowych klientów szpitalnych skróciło się z sześciu do dwóch tygodni.
Ponieważ Zippy korzysta wyłącznie z aktualnych, zweryfikowanych dokumentów, odpowiedzi są spójniejsze, a błędy zdarzają się rzadziej. Dzięki funkcji zgłaszania uwag pracownicy mogą od razu oznaczyć nieprawidłowe lub nieaktualne treści, co pozwala utrzymać bazę wiedzy w aktualnym stanie.
Czym jest retrieval-augmented generation?
RAG wzbogaca duże modele językowe o zewnętrzne źródła wiedzy i działa w dwóch krokach:
- Wyszukiwanie (retrieval): system przeszukuje bazę danych lub zbiór dokumentów w poszukiwaniu informacji związanych z pytaniem.
- Generowanie (generation): na tej podstawie model językowy formułuje rzeczową odpowiedź uwzględniającą kontekst.
Ponieważ wiedza jest pobierana w chwili zadania pytania, można ją aktualizować w dowolnym momencie bez ponownego trenowania modelu.
RAG czy fine-tuning?
Model językowy można też dopasować do danej dziedziny przez dostrajanie (fine-tuning), czyli dalsze trenowanie na własnych danych. Wymaga to więcej pracy i trzeba to powtarzać, gdy zmieniają się treści. RAG dodaje natomiast do każdego zapytania odpowiednie informacje, podobnie jak człowiek, który przed udzieleniem odpowiedzi zagląda do właściwego segregatora.
| RAG | Fine-tuning | |
|---|---|---|
| Aktualizacja wiedzy | wymiana dokumentów, działa od razu | wymaga ponownego trenowania |
| Wskazanie źródła | każda odpowiedź z dokumentem i stroną | brak |
| Nakład pracy | średni | wysoki |
| Sprawdza się, gdy | wiedza często się zmienia i potrzebne są dowody | słownictwo lub styl odpowiedzi są bardzo specjalistyczne |
W przypadku kwestionariuszy bezpieczeństwa, w których odpowiedzi muszą dać się sprawdzić, a dokumenty źródłowe się zmieniają, RAG jest więc właściwym wyborem. Oba podejścia można też łączyć. Więcej na ten temat piszemy w artykule o dedykowanych modelach LLM.
Jak budujemy systemy RAG
Tworzymy skalowalne, gotowe do produkcji architektury RAG, dopasowane do wymagań konkretnej firmy:
- modułowe komponenty do przygotowania danych, embeddingu, wyszukiwania wektorowego i orkiestracji LLM,
- wdrożenie w chmurze, hybrydowo lub on-premise,
- monitoring i ocena jakości odpowiedzi, trafności kontekstu i bezpieczeństwa danych,
- integracja z istniejącymi systemami, takimi jak SharePoint, Salesforce, Confluence, platformy ERP czy oprogramowanie własne.
Dzięki temu firmy mogą w ciągu kilku tygodni przejść od koncepcji do aplikacji gotowej do wdrożenia produkcyjnego. Więcej na stronie Systemy RAG.
Wyzwania i czynniki sukcesu
Zbudowanie solidnego rozwiązania RAG jest wymagające, ale da się je dobrze zaplanować. Typowe wyzwania to wysokie wymagania wobec jakości i struktury danych, wybór i skalowanie bazy wektorowej, ochrona danych i governance oraz integracja z istniejącymi systemami i procesami.
Udane projekty mają jasno określone zastosowanie i cel, powstają iteracyjnie, zaczynając od wczesnego prototypu, korzystają z dobrze dobranego modelu językowego i frameworka oraz są stale monitorowane. Szczegóły opisujemy w artykule o niezawodnych systemach RAG.

Chcesz przyspieszyć dokumentację i compliance dzięki RAG?
Razem z Tobą ustalamy, na które kwestionariusze, audyty lub wymagane dowody da się odpowiedzieć na podstawie Twoich dokumentów i jak mógłby wyglądać prototyp na prawdziwych danych.
Zapytaj o analizę procesuNajczęściej zadawane pytania
Asystent RAG znajduje do każdego pytania odpowiednie fragmenty polityk i dokumentacji technicznej, a następnie przygotowuje odpowiedź z nazwą dokumentu i numerem strony. Specjaliści sprawdzają odpowiedzi, zamiast samodzielnie je zestawiać.
W apoQlar czas obsługi skrócił się o 75%, z około miesiąca do niecałego tygodnia. Wdrożenie nowych klientów szpitalnych trwa dwa tygodnie zamiast sześciu.
Azure OpenAI Services jako model językowy, ChromaDB jako baza wektorowa i zabezpieczona infrastruktura Azure, z logowaniem przez Microsoft Entra ID i monitoringiem LLM.
W przypadku wiedzy, która się zmienia i musi być poparta dowodami, zwykle tak, bo dokumenty można aktualizować bez ponownego trenowania, a każda odpowiedź ma źródło. Fine-tuning opłaca się przy bardzo specjalistycznym słownictwie lub z góry ustalonym stylu odpowiedzi. Oba podejścia można łączyć.
Aleksandra od 2021 roku tworzy w theBlue.ai dedykowane rozwiązania AI. Specjalizuje się w systemach agentowych i wdrożeniach lokalnych modeli LLM dopasowanych do potrzeb firm. Jako AI Engineer pomaga organizacjom automatyzować procesy za pomocą systemów gotowych do pracy produkcyjnej: od modeli open source działających on-premise po wewnętrzne bazy wiedzy oparte na RAG dla branż regulowanych. Na bieżąco poszerza swoją wiedzę w szybko zmieniającym się świecie sztucznej inteligencji.
W swoich artykułach dzieli się doświadczeniem z prawdziwych projektów enterprise AI i pokazuje, że wdrożenie AI w firmie nie musi być skomplikowane.