KI-Architektur & Integration · Lokale LLMs
Lokale LLMs in der Praxis: Wie wir sie bei theBlue.ai einsetzen
Für viele KI-Aufgaben ist es günstiger, sicherer und besser steuerbar, ein Open-Source-Modell auf eigener Infrastruktur zu betreiben, statt Daten an eine Cloud-API zu schicken. Drei Systeme aus unserem Alltag zeigen, wo lokale Modelle ihre Stärken ausspielen und wo sie an Grenzen stoßen.
 Aleksandra Osztynowicz
Das Wichtigste in Kürze
- Lokale LLMs lohnen sich bei hohem Volumen, sensiblen Daten oder beidem. Ohne diese Anforderungen ist eine Cloud-API meist die ehrlichere Wahl.
- Das Modell richtet sich nach der Aufgabe: Gemma 4 26B, wo Nutzer warten (88 Token pro Sekunde), die größere 31B-Variante für Hintergrundjobs, bei denen Genauigkeit zählt.
- Quantisierung, MTP-Schicht, Mixture-of-Experts und der Serving-Stack können den Durchsatz auf denselben GPUs mehr als verdoppeln.
- Lokal fällt der externe Datenabfluss als Risiko weg. Dafür liegen Anwendungssicherheit, Zugriffskontrolle und Betrieb beim eigenen Team.
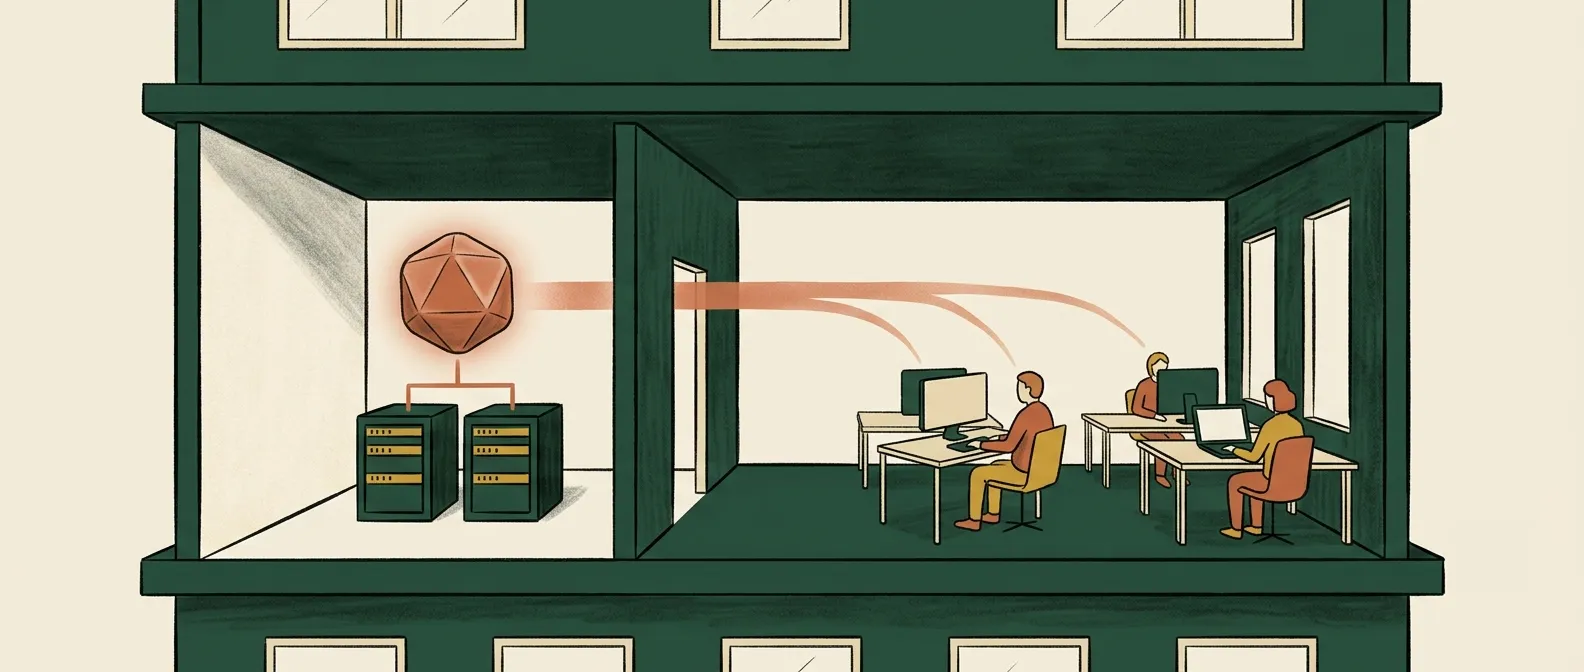
Rund um Large Language Models (LLMs) hat sich ein Standardvorgehen etabliert: Sobald eine Aufgabe mit KI gelöst werden soll, gehen die Daten an ChatGPT oder ein vergleichbares Cloud-Tool. Oft ist das die richtige Wahl. Für eine ganze Klasse von Aufgaben ist es jedoch günstiger, sicherer und besser steuerbar, LLMs lokal zu betreiben, also ein Open-Source-Modell auf einer Infrastruktur laufen zu lassen, die man selbst kontrolliert.
Diese Einschätzung beruht auf Systemen, die wir selbst gebaut haben und täglich nutzen. Im Folgenden beschreiben wir, wie das in der Praxis aussieht, wo lokale Modelle einen echten Vorteil bieten und wo sie an ihre Grenzen stoßen.
Was ist ein lokales LLM?
Ein lokales LLM ist ein Open-Source-Modell, zum Beispiel aus den Familien Gemma, Llama oder Qwen, das auf eigener Hardware läuft statt auf dem Server eines externen Anbieters. Für ein Unternehmen hat das zwei entscheidende Folgen. Erstens verlassen die Daten die eigene Infrastruktur nicht. Zweitens fallen keine Gebühren pro Anfrage an. Zusammen verändern diese beiden Punkte das Kosten- und das Risikoprofil vieler Anwendungen.
Drei Systeme, drei Erkenntnisse
Wir betreiben mehrere solcher Systeme. Drei davon beschreiben wir hier, beginnend mit dem, das am besten zeigt, was es heißt, ein Modell an eine Aufgabe anzupassen.
1.Ausschreibungsportal: öffentliche Ausschreibungen im großen Maßstab prüfen
Ein internes Portal sucht automatisch nach öffentlichen Ausschreibungen in unseren Themenfeldern und lädt alles herunter, was dazu verfügbar ist: Beschreibungen, Anforderungen, Anhänge und begleitende Unterlagen. Nach einer Vorfilterung übernimmt das lokale Modell Gemma 4 26B (26 Milliarden Parameter) mit einer MTP-Schicht (Multi-Token-Prediction). Es erledigt zwei Stufen:
- Eignungsprüfung: Das Modell liest den Kopf jeder Ausschreibung, also Titel, Auftraggeber, Kategorie und Namen der Anhänge, und gibt ein kurzes Urteil ab, ob sie zu unserem Unternehmensprofil passt, mit Konfidenzwert und kurzer Begründung. Danach bleiben nur relevante Ausschreibungen auf der Liste.
- Analyse der Unterlagen: Sind Dokumentation und Anhänge heruntergeladen, liefert das Modell eine strukturierte Zusammenfassung: vertragliche, finanzielle, personelle und leistungsbezogene Anforderungen, nötige Zertifikate, Höhe und Form der Bietungsgarantie, wichtige Termine, Risiken wie Vertragsstrafen und eine Empfehlung (EMPFEHLEN, PRÜFEN oder ABLEHNEN) mit Begründung.
Die Mengen sind real. An einem Tag verarbeitet das Modell 15 bis 20 Millionen Token, das entspricht etwa 15.000 A4-Seiten. Aufs Jahr gerechnet sind das 5,5 bis 7,3 Milliarden Token. Dieselbe Last über GPT-5 zu verarbeiten, würde allein für die Input-Token 6.875 bis 9.125 US-Dollar kosten.
Berechnet nach den offiziellen OpenAI-Preisen, Stand Juli 2026
Die Modellwahl war bewusst. Im Portal wartet ein Nutzer aktiv auf das Ergebnis, also zählt die Antwortzeit. Auf unserer Hardware erzeugt Gemma 4 26B rund 88 Token pro Sekunde, die größere 31B-Variante 40. Die 31B-Version ist etwas genauer, aber mit Blick auf die Nutzererfahrung ist das 26B-Modell hier der richtige Kompromiss. Seine Geschwindigkeit verdankt es der MTP-Schicht und der Mixture-of-Experts-Architektur (MoE), beide weiter unten beschrieben. Dazu kommt ein großes Kontextfenster, mit dem eine ganze Ausschreibung samt Anhängen in einem Durchgang analysiert wird, und das Modell beherrscht Polnisch gut.
Wer Genauigkeit, Latenz, Kontextfenster, Sprachunterstützung und Hardwarebedarf gegeneinander abwägt, kommt in diesem Fall zu einem klaren Ergebnis: Große Mengen an Ausschreibungen lassen sich verarbeiten, ohne über API-Kosten oder Anfragelimits nachzudenken.
2.Policy Insider: wo Preise pro Anfrage nicht mehr aufgehen
Policy Insider ist eine KI-gestützte Plattform für Policy- und Regulatory-Intelligence. Sie hilft Teams aus Public Affairs, Government Relations und strategischer Beratung, politische und regulatorische Entwicklungen im großen Maßstab zu verfolgen, ohne manuelle Recherche, Tabellen oder verstreute Tools. Hier analysiert das lokale LLM Gemma 4 31B die Inhalte sehr vieler politikrelevanter Webseiten, rund 28 Millionen Token pro Tag. Für jede Seite bereitet das Modell den Inhalt auf, fasst ihn zusammen und markiert, ob er zu einem Thema passt. Relevante Seiten fließen in Reports, Newsletter und Heatmaps, die zeigen, wo sich besonders viel bewegt.
Hier nutzen wir bewusst das größere, genauere Modell mit 31 Milliarden Parametern. Policy Insider verarbeitet Daten in zyklischen Hintergrundjobs, ob ein Batch eine Minute oder dreißig dauert, spielt keine Rolle. Entscheidend ist die Genauigkeit der Klassifizierung, denn von ihr hängt die Qualität der Reports ab. Das Prinzip bleibt dasselbe: Das Modell richtet sich nach der Aufgabe.
Zugleich ist das ein Fall, in dem eine bezahlte API wirtschaftlich nicht mehr aufgeht. Millionen Token pro Zyklus bedeuten hohe, stetig wachsende Kosten und ständige Probleme mit Anfragelimits. Mit einem lokalen LLM kostet jede weitere Webseite praktisch nichts: Die Hardware wird einmal bezahlt, und die Menge ist keine finanzielle Grenze mehr. Mehr zur Plattform zeigt unsere Referenz Policy Insider.
3.Interner Chatbot mit RAG: Daten, die im Unternehmen bleiben
Kosten und Skalierung sind die eine Seite, Datenkontrolle die andere. Das dritte System dient unserem eigenen Team: ein Chatbot, der unsere interne Dokumentation durchsucht und Fragen beantwortet. Statt sich durch Dutzende Dokumente zu arbeiten, stellt man eine Frage in natürlicher Sprache und bekommt eine Antwort mit Verweis auf die Quelle. Der Aufbau folgt dem Muster Retrieval-Augmented Generation (RAG): Das System sucht zuerst passende Abschnitte in unseren Dokumenten, und das Modell formuliert daraus die Antwort, statt sich auf Wissen aus dem Training zu stützen.
Das System läuft lokal auf unseren eigenen GPUs, diesmal mit einem Modell außerhalb der Gemma-Familie: Qwen3 30B. Hier zeigt sich das Prinzip aller drei Umsetzungen am deutlichsten: Wer das Modell nach der Aufgabe wählt, muss bei keiner Modellfamilie bleiben. Qwen3 führt Dialoge gut, kommt mit langen Dokumenten zurecht und bleibt trotz nominell 30 Milliarden Parametern schnell, weil jede Anfrage nur einen Bruchteil davon aktiviert (Mixture-of-Experts). Deshalb reagiert es auch dann zügig, wenn viele Personen gleichzeitig fragen, und kann für jede Antwort auf große Teile der Dokumentation zugreifen.
Am wichtigsten ist, wo die Arbeit stattfindet: Unser internes Wissen, also Projekte, Angebote und Know-how, geht nie an einen externen Anbieter. Für uns bedeutet das Ruhe im Hinterkopf. Für Kunden aus regulierten Branchen wie Finanzwesen, Versicherung, Verwaltung oder Gesundheit kann es die Bedingung sein, ohne die über eine KI-Einführung gar nicht erst gesprochen wird.
Die drei Systeme im Überblick
| System | Modell | Worauf es ankommt |
|---|---|---|
| Ausschreibungsportal | Gemma 4 26B mit MTP | Antwortzeit, 15 bis 20 Mio. Token pro Tag |
| Policy Insider | Gemma 4 31B | Genauigkeit, rund 28 Mio. Token pro Tag |
| Interner Chatbot | Qwen3 30B (MoE) | Daten bleiben intern, viele Nutzer gleichzeitig |
Grenzen und Trade-offs
Lokale LLMs passen nicht für jeden Fall. Diese Grenzen sollte man kennen:
- Vorlaufkosten: Hardware ist eine Investition. Sie rechnet sich bei ausreichendem Volumen und über einen genügend langen Zeitraum. Bei kleinem Umfang oder gelegentlicher Nutzung kann eine Cloud-API günstiger sein.
- Hardware als Obergrenze: Das Modell läuft auf den eigenen Maschinen und ist durch deren Rechenleistung, Speicher und Architektur begrenzt. Die größten Modelle lassen sich auf einem bestimmten Setup womöglich gar nicht betreiben. Eine Cloud-API lässt sich dagegen von jedem alten Laptop mit Internetzugang aufrufen, weil die Rechenleistung beim Anbieter liegt.
- Qualitätslücke bei den schwierigsten Aufgaben: Für komplexe Probleme mit tiefem Reasoning liefern führende kommerzielle Modelle weiterhin oft bessere Ergebnisse. Nicht jede Aufgabe braucht aber die höchste Reasoning-Klasse, deshalb lohnt es sich, das Modell passend zu wählen.
- Laufender Betrieb: Das Modell muss gehostet, überwacht und aktualisiert werden. Das ist eine dauerhafte betriebliche Aufgabe.
LLMs lokal betreiben: worauf es ankommt
Wie gut ein lokales Deployment funktioniert, hängt ebenso davon ab, wie das Modell bereitgestellt wird, wie von der Wahl des Modells. Einige technische Entscheidungen haben großen Einfluss auf Kosten, Qualität und Geschwindigkeit.
- Quantisierung: Die Gewichte des Modells lassen sich mit geringerer Präzision speichern, etwa in 8 oder 4 Bit statt in der Standardvariante. Das spart GPU-Speicher und beschleunigt meist die Inferenz. Je stärker die Quantisierung, desto größer die Einsparung, aber auch der mögliche Qualitätsverlust. Gesucht ist die Stufe, bei der das Modell schneller läuft und weniger Speicher belegt, während die Qualität für die Aufgabe ausreicht. Deshalb prüfen wir jede Stufe mit Qualitätstests auf unseren eigenen Daten.
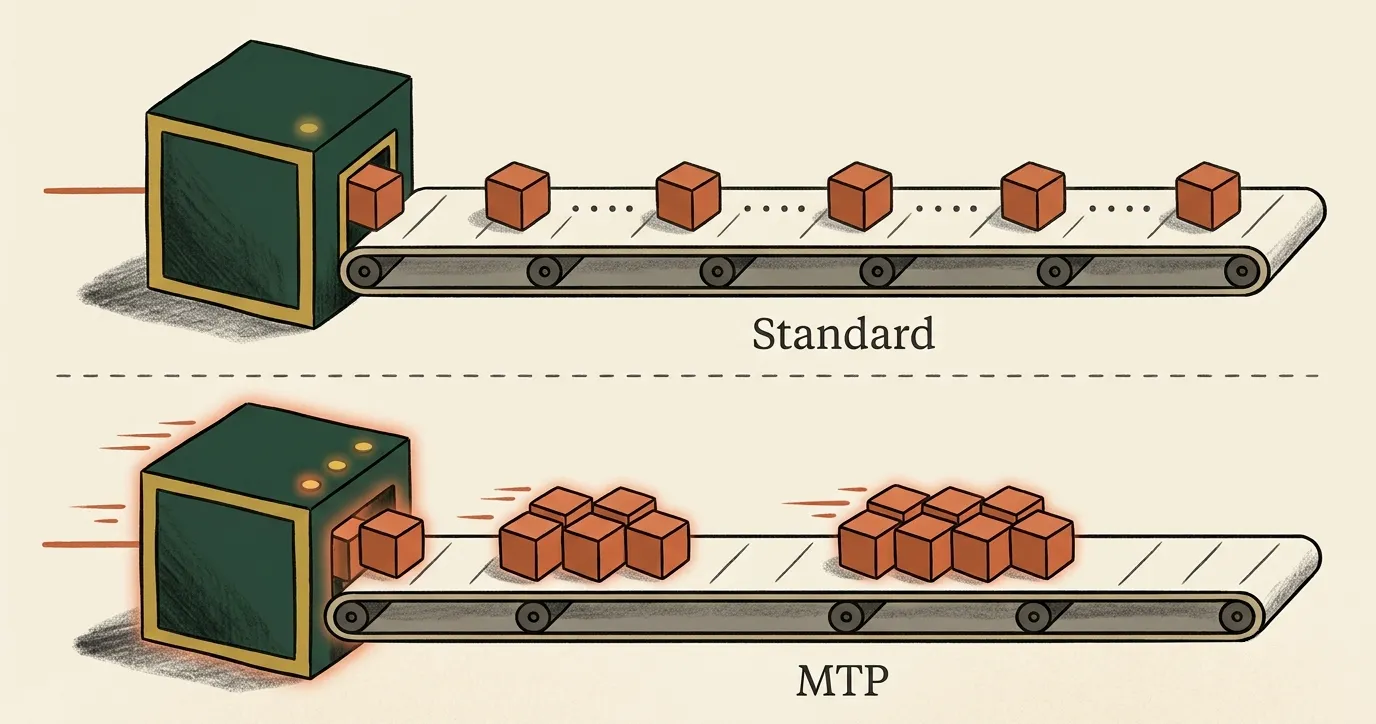
- MTP-Schicht (Multi-Token-Prediction): Ein Standardmodell erzeugt seine Antwort Token für Token, was die Geschwindigkeit begrenzt. Eine MTP-Schicht sagt mehrere Token in einem Schritt vorher und beschleunigt so die Generierung, ohne die Qualität zu verschlechtern. In unserem Test hob sie den Durchsatz des Portalmodells von rund 72 auf 88 Token pro Sekunde, bei der 31B-Variante von 16 auf 40, also auf mehr als das Doppelte. Allerdings gibt es MTP nicht für jedes Modell, und die Schicht macht das Modell etwas größer.
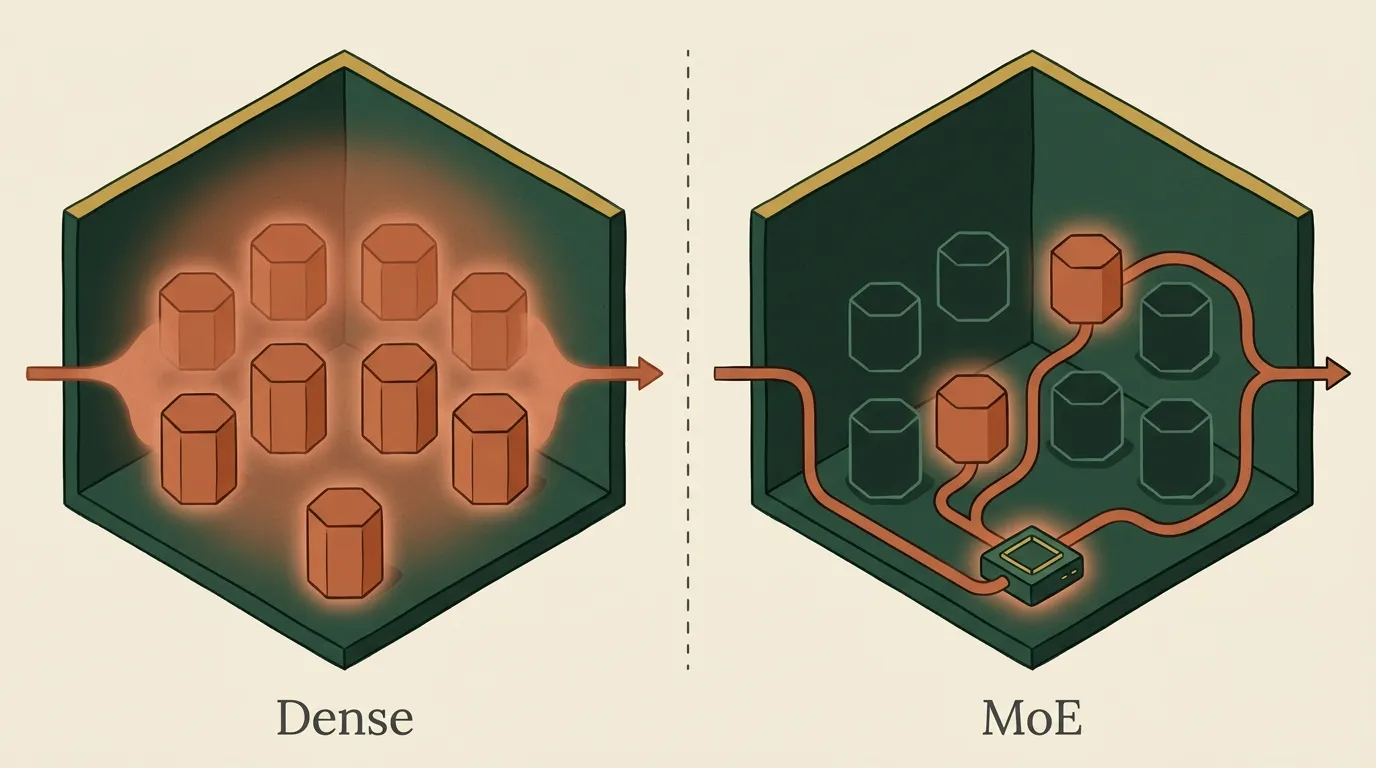
- Mixture-of-Experts (MoE): Ein dichtes Modell nutzt für jedes Token alle Parameter. Ein MoE-Modell ist in viele spezialisierte Teilnetze aufgeteilt, die Experten, und ein kleiner Router wählt pro Token nur einige davon aus. Auf dem Papier hat das Modell Dutzende Milliarden Parameter, eine Anfrage aktiviert aber nur einen Bruchteil. Ein MoE-Modell läuft deshalb deutlich schneller und günstiger als ein dichtes Modell gleicher Größe und behält einen Großteil der Qualität. Das Modell im Ausschreibungsportal aktiviert pro Anfrage nur rund 4 seiner 26 Milliarden Parameter. Der Haken liegt bei der Hardware: Alle Experten müssen trotzdem in den GPU-Speicher passen.
- Kontextfenster und Cache: Je länger der übergebene Text, etwa eine ganze Ausschreibung mit Anhängen, desto mehr GPU-Speicher belegt der Cache, in dem das Modell den bereits verarbeiteten Kontext ablegt (KV-Cache). Wie viel Kontext praktisch nutzbar ist, hängt auch davon ab, wie viel Speicher nach dem Laden der Gewichte übrig bleibt. Das muss von Anfang an eingeplant werden.
- Serving-Software: Der Serving-Stack bestimmt, wie viel Durchsatz dieselbe Hardware liefert. vLLM und SGLang sind auf hohen Durchsatz und viele parallele Anfragen ausgelegt und passen zum Produktivbetrieb. Ollama und llama.cpp sind schneller aufgesetzt und eignen sich für Prototypen oder kleinere Deployments, verlieren aber unter Last an Leistung.
- Viele parallele Anfragen: Nutzen viele Personen oder Prozesse das Modell gleichzeitig, kommt es darauf an, parallele Anfragen zu effizienten Batches zu bündeln (Continuous Batching). Ausgereifte Serving-Software erledigt das automatisch. Deshalb bedient dieselbe Hardware ein Vielfaches der Anfragen einer rein sequenziellen Verarbeitung.
- Hardware-Auswahl: Der Engpass ist meist der GPU-Speicher. Er muss die Gewichte, das Kontextfenster und einen Puffer für parallele Anfragen aufnehmen. Ist die Hardware frei wählbar, beginnt die Planung mit der Berechnung, wie viel Speicher das gewünschte Modell mit der geplanten Quantisierung und der erwarteten Last braucht.
Diese Entscheidungen hängen zusammen. Quantisierung, Serving-Stack und Hardware greifen ineinander, und ein Fehler an einer Stelle zeigt sich meist als schlechte Leistung an einer anderen.
Wann sich ein lokales Modell lohnt und wann nicht
Die drei Systeme treffen jeweils den Punkt, an dem der lokale Betrieb die bessere Option ist. Ebenso viele Fälle sprechen für eine Cloud-API.
Ein lokales Modell ist meist sinnvoll, wenn
- Daten das Unternehmen nicht verlassen dürfen: Personenbezogene Daten unter der DSGVO, Patientenakten, Finanzinformationen, Geschäftsgeheimnisse oder Unterlagen, die branchenspezifischen Regeln unterliegen (Finanzwesen, Versicherung, Gesundheit, öffentliche Verwaltung), dürfen oft gar nicht an externe Anbieter gehen oder nur mit Vorkehrungen, die aufwendiger sind als ein eigener Betrieb. In regulierten Branchen ist der lokale Betrieb häufig die Voraussetzung für das Projekt.
- das Volumen hoch und planbar ist: Bei Millionen Token pro Tag in wiederkehrendem Muster übersteigen die API-Kosten schnell die abgeschriebenen Kosten eigener Hardware. Ausschreibungsportal und Policy Insider gehören hierher.
- volle Kontrolle über das Modell nötig ist: Fine-Tuning auf eigenen Daten, eine eingefrorene Modellversion, deren Verhalten sich nach Updates des Anbieters nicht ändert, eigene Quantisierungen oder besondere Serving-Setups sind mit einer geschlossenen API nicht oder nur stark eingeschränkt möglich.
Eine Cloud-API ist meist sinnvoll, wenn
- das Volumen gering oder unvorhersehbar ist: Bei gelegentlicher Nutzung holt die Abschreibung der Hardware die Preise pro Anfrage nie ein.
- höchste Reasoning-Qualität gebraucht wird: Bei den schwierigsten Aufgaben liegen kommerzielle Frontier-Modelle weiter vorn. Bestimmt die Qualität bei den härtesten Anfragen den Wert des ganzen Systems, verdient sich ein Cloud-Modell dort seinen Preis. Lokale Modelle holen allerdings auf, Kimi K3 ist ein gutes Beispiel.
- Personal für den Betrieb fehlt: Jemand muss die GPUs am Laufen halten, den Serving-Stack aktualisieren und auf Störungen reagieren. Fehlt diese Kapazität im Haus, ist eine API die ehrlichste Wahl.
Ein Wort zur Datensicherheit
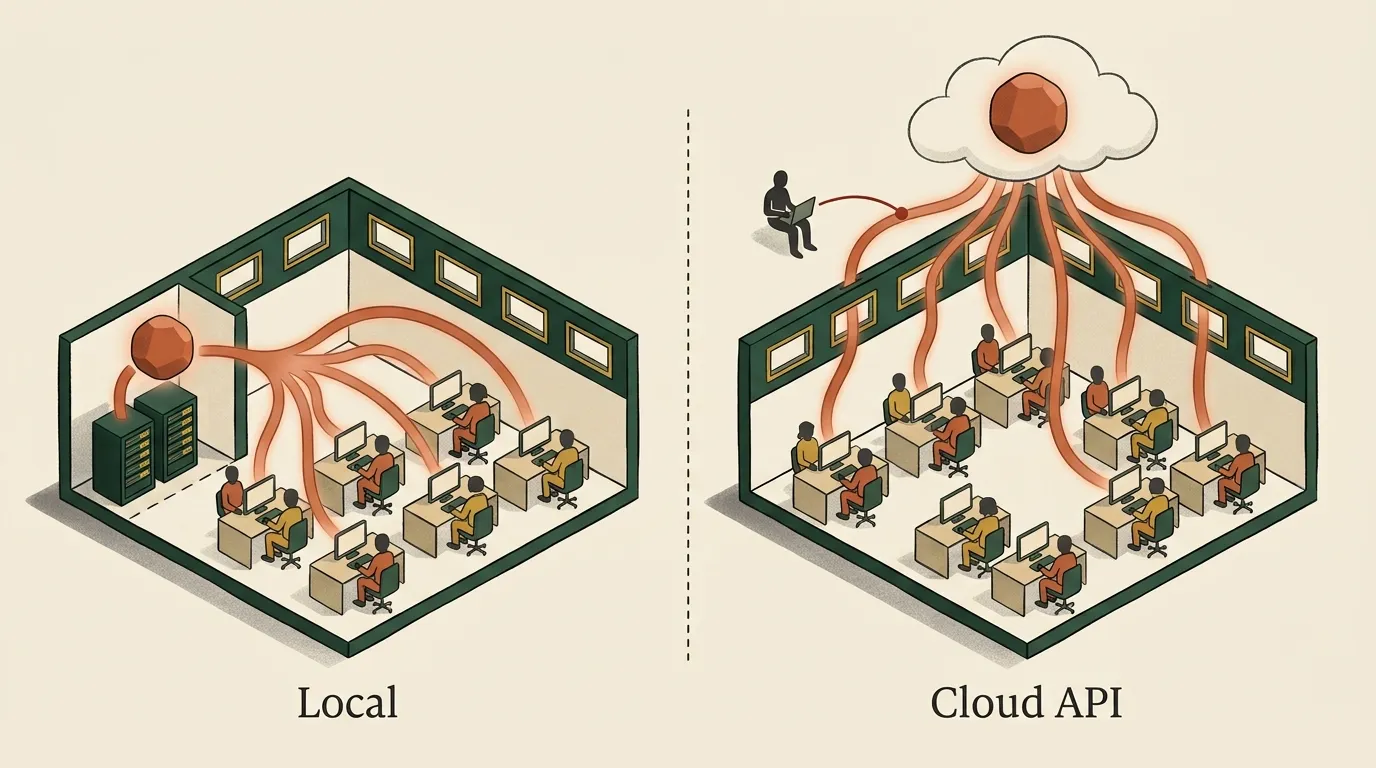
Das Sicherheitsargument für lokale Modelle reicht weiter als der Satz „Ihre Daten verlassen das Gebäude nicht“ und ist zugleich vielschichtiger.
Ein lokales Deployment hält Daten in einer Infrastruktur, die Sie kontrollieren: mit Ihren Zugriffsrichtlinien, Ihrem Logging und Ihren Aufbewahrungsregeln. Es gibt keine AGB eines Dritten, die mit den eigenen Compliance-Pflichten abgeglichen werden müssen, keine Unklarheit, ob Anfragen später für das Training genutzt werden, und keine Abhängigkeit von der Sicherheitslage des Anbieters. In regulierten Branchen verkürzt das die Compliance-Abstimmung oft von Monaten auf Tage.
Automatisch sicher ist ein Modell auf eigener Hardware trotzdem nicht. Es ist nur so sicher wie seine Umgebung. Zugriffe müssen authentifiziert und protokolliert werden, Prompts und Ausgaben können sensible Daten enthalten, und RAG-Systeme übernehmen die Zugriffsrechte des Dokumentenspeichers: Ein Chatbot, der Dateien indexiert, die ein Nutzer nicht sehen darf, gibt deren Inhalte bereitwillig preis.
Ein lokales Modell beseitigt eine große Risikokategorie, den externen Datenabfluss, und tauscht sie gegen eine kleinere, vertrautere: die Sicherheit von Anwendung und Infrastruktur. Für die meisten Organisationen ist das ein guter Tausch, sofern sie die zweite Kategorie ernst nehmen.
Fazit: Lokale LLMs sind eine Frage der Aufgabe
Lokale LLMs sind eine dauerhafte betriebliche Verpflichtung. Wo Volumen hoch ist oder Daten das Unternehmen nicht verlassen dürfen, sind sie oft die wirtschaftlichere und manchmal die einzige zulässige Lösung. Wie das Modell betrieben wird, zählt dabei so viel wie die Wahl des Modells.
Bei theBlue.ai setzen wir lokale LLMs für Kunden und im eigenen Unternehmen ein. Aus diesen Projekten wissen wir, wo die echten Trade-offs liegen und wann ein lokales Modell, eine Cloud-API oder ein hybrides Setup die richtige Antwort ist. Mehr dazu auf unserer Seite zur LLM-Entwicklung.
Lokal oder Cloud für Ihre Anwendung?
Im KI Discovery Workshop klären wir in ein bis drei Wochen genau diese Frage und geben Ihnen einen Architekturvorschlag an die Hand, mit dem Sie arbeiten können.
Workshop anfragenHäufige Fragen
Ein lokales LLM ist ein Open-Source-Modell, etwa aus den Familien Gemma, Llama oder Qwen, das auf eigener Hardware läuft statt beim Server eines externen Anbieters. Die Daten verlassen das Unternehmen nicht, und es fallen keine Gebühren pro Anfrage an.
Wenn Daten das Unternehmen nicht verlassen dürfen, wenn das Volumen hoch und planbar ist, etwa Millionen Token pro Tag, oder wenn volle Kontrolle über das Modell nötig ist. Bei geringem oder schwankendem Volumen, höchsten Anforderungen an das Reasoning oder fehlendem Betriebspersonal ist eine Cloud-API meist besser.
Unser Ausschreibungsportal verarbeitet 15 bis 20 Millionen Token pro Tag, 5,5 bis 7,3 Milliarden im Jahr. Über GPT-5 würde das allein für Input-Token 6.875 bis 9.125 US-Dollar kosten, nach den OpenAI-Preisen vom Juli 2026. Lokal wird die Hardware einmal bezahlt.
Nein. Es beseitigt das Risiko des externen Datenabflusses, ist aber nur so sicher wie seine Umgebung. Zugriffe müssen authentifiziert und protokolliert werden, und RAG-Systeme übernehmen die Zugriffsrechte des Dokumentenspeichers.
Aleksandra entwickelt seit 2021 bei theBlue.ai maßgeschneiderte KI-Lösungen mit Schwerpunkt auf agentischen Implementierungen und lokalen LLM-Deployments, die passgenau auf Unternehmensanforderungen zugeschnitten sind. Als AI Engineer hilft sie Organisationen dabei, ihre Prozesse mit produktionsreifen Systemen zu automatisieren, von On-Premise-Open-Source-Modellen bis hin zu RAG-basierten internen Wissensdatenbanken für regulierte Branchen, und erweitert ihr Wissen kontinuierlich in der sich rasant wandelnden Welt der Künstlichen Intelligenz.
In ihren Artikeln teilt sie praktische Erfahrungen aus realen Enterprise-KI-Projekten und zeigt: KI im Unternehmen einzuführen muss nicht kompliziert sein.