
Architektura i integracja AI · Lokalne LLM
Lokalne modele LLM w praktyce: jak wykorzystujemy je w theBlue.ai
W wielu zadaniach AI model open source na własnej infrastrukturze jest tańszy, bezpieczniejszy i łatwiejszy do kontrolowania niż wysyłanie danych do API w chmurze. Trzy systemy z naszej codziennej pracy pokazują, gdzie modele lokalne wykorzystują swoje atuty, a gdzie dochodzą do granic.
 Aleksandra Osztynowicz
Najważniejsze w skrócie
- Lokalne modele LLM bronią się przy dużym wolumenie, przy wrażliwych danych albo gdy zachodzi jedno i drugie. Bez tych wymagań uczciwszym wyborem jest zwykle API w chmurze.
- O modelu decyduje zadanie: Gemma 4 26B tam, gdzie użytkownik czeka (88 tokenów na sekundę), większy wariant 31B w zadaniach w tle, w których liczy się dokładność.
- Kwantyzacja, warstwa MTP, mixture-of-experts i stos serwujący potrafią ponad dwukrotnie zwiększyć przepustowość na tych samych GPU.
- Lokalne uruchomienie usuwa ryzyko wypływu danych na zewnątrz. W zamian bezpieczeństwo aplikacji, kontrola dostępu i utrzymanie spoczywają na Twoim zespole.
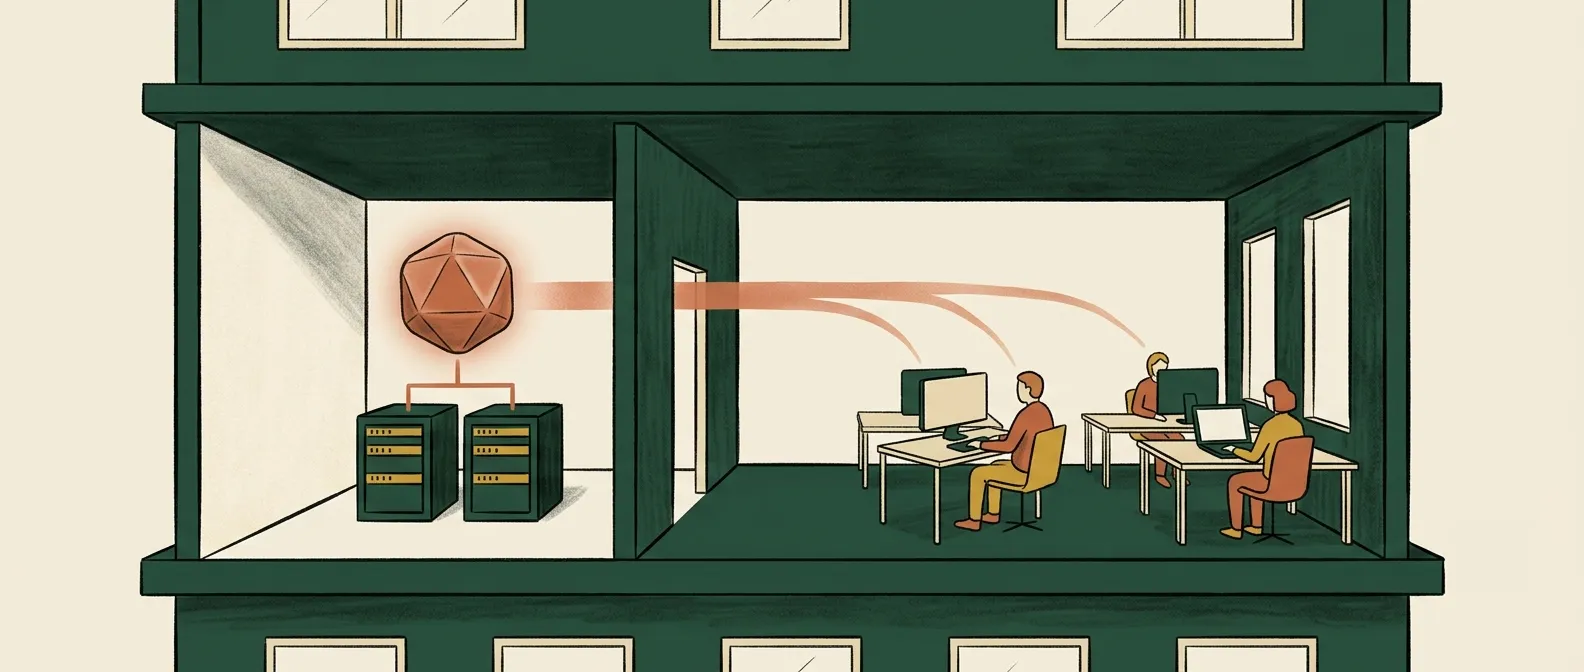
Wokół dużych modeli językowych (LLM) ukształtowało się domyślne podejście: gdy tylko zadanie wymaga AI, dane trafiają do ChatGPT lub podobnego narzędzia w chmurze. Często to właściwy wybór. Dla całej klasy zadań lokalne uruchamianie modeli LLM, czyli praca z modelem open source na infrastrukturze pod Twoją kontrolą, okazuje się jednak tańsze, bezpieczniejsze i łatwiejsze do nadzorowania.
Ten pogląd opieramy na systemach, które sami zbudowaliśmy i z których korzystamy na co dzień. Poniżej opisujemy, jak wygląda to w praktyce, gdzie modele lokalne dają realną przewagę i gdzie dochodzą do swoich granic.
Czym jest lokalny LLM?
Lokalny LLM to model open source, na przykład z rodziny Gemma, Llama lub Qwen, uruchomiony na własnym sprzęcie, a nie na serwerze zewnętrznego dostawcy. Dla firmy istotne są dwie konsekwencje. Po pierwsze, dane nigdy nie opuszczają infrastruktury firmy. Po drugie, nie ma opłaty za każde zapytanie. Razem te dwa czynniki zmieniają zarówno profil kosztowy, jak i profil ryzyka wielu zastosowań.
Trzy systemy, trzy lekcje
Uruchomiliśmy kilka takich systemów. Opisujemy tu trzy z nich, zaczynając od tego, który najlepiej pokazuje, co znaczy dopasowanie modelu do zadania.
1.Portal przetargowy: przesiewanie zamówień publicznych na dużą skalę
Wewnętrzny portal automatycznie wyszukuje przetargi publiczne w interesujących nas obszarach i pobiera wszystko, co jest o nich dostępne: opisy, wymagania, załączniki i dokumentację uzupełniającą. Po wstępnym odfiltrowaniu pałeczkę przejmuje lokalny model Gemma 4 26B (26 miliardów parametrów) z warstwą MTP (multi-token prediction). Odpowiada za dwa etapy:
- Kwalifikacja wstępna: model odczytuje nagłówek każdego przetargu, czyli tytuł, zamawiającego, kategorię i nazwy załączników, i wydaje krótką ocenę, czy przetarg pasuje do profilu naszej firmy, wraz z poziomem pewności i krótkim uzasadnieniem. Na liście zostają potem tylko istotne postępowania.
- Analiza dokumentacji: po pobraniu dokumentacji i załączników model zwraca ustrukturyzowane podsumowanie: wymagania umowne, finansowe, kadrowe i dotyczące doświadczenia, wymagane certyfikaty, wysokość i formę wadium, kluczowe terminy, ryzyka, np. kary umowne, oraz rekomendację (REKOMENDACJA, DO ROZWAŻENIA lub ODRZUCENIE) z uzasadnieniem.
Skala jest duża. W ciągu jednego dnia model przetwarza od 15 do 20 milionów tokenów, czyli mniej więcej 15 000 stron A4. W skali roku daje to 5,5 do 7,3 miliarda tokenów. Przetworzenie tego samego wolumenu przez GPT-5 kosztowałoby 6875 do 9125 USD wyłącznie za tokeny wejściowe.
Wyliczenie na podstawie oficjalnego cennika OpenAI z lipca 2026
Wybór modelu był świadomy. W portalu użytkownik czeka na wynik, więc liczy się czas odpowiedzi. Na naszym sprzęcie Gemma 4 26B generuje około 88 tokenów na sekundę, większy wariant 31B około 40. Wersja 31B jest nieco dokładniejsza, ale z myślą o komforcie użytkownika model 26B jest tu właściwym kompromisem. Swoją szybkość zawdzięcza warstwie MTP i architekturze mixture-of-experts (MoE), które opisujemy niżej. Ma też duże okno kontekstowe, dzięki czemu analizujemy cały przetarg z załącznikami w jednym przebiegu, i dobrze radzi sobie z językiem polskim.
Zestawienie dokładności, opóźnienia, okna kontekstowego, obsługi języka i wymagań sprzętowych daje w tym przypadku jasny wynik: duże wolumeny przetargów można przetwarzać bez obaw o koszty API czy limity zapytań.
2.Policy Insider: kiedy rozliczanie za zapytanie przestaje się opłacać
Policy Insider to oparta na AI platforma do monitorowania polityki i regulacji. Pomaga zespołom public affairs, relacji z administracją i doradztwa strategicznego śledzić zmiany polityczne i regulacyjne na dużą skalę, bez ręcznego monitorowania, arkuszy kalkulacyjnych i rozproszonych narzędzi. Lokalny model Gemma 4 31B analizuje tu treści z dużej liczby serwisów poświęconych polityce, około 28 milionów tokenów dziennie. Dla każdego serwisu model przygotowuje treść, streszcza ją i oznacza, czy odpowiada danemu tematowi. Istotne serwisy trafiają do raportów, newsletterów i map ciepła, które pokazują, gdzie zmiany są najbardziej intensywne.
Świadomie korzystamy tu z większego, dokładniejszego modelu o 31 miliardach parametrów. Policy Insider przetwarza dane w cyklicznych zadaniach w tle, więc nie ma znaczenia, czy jedna partia zajmie minutę, czy trzydzieści. Liczy się dokładność klasyfikacji, bo od niej zależy jakość raportów. Zasada pozostaje ta sama: o modelu decyduje zadanie.
To także przypadek, w którym płatne API przestaje mieć sens ekonomiczny. Miliony tokenów na cykl oznaczają wysokie, stale rosnące koszty i ciągłe problemy z limitami zapytań. Przy lokalnym LLM każdy kolejny serwis nie kosztuje praktycznie nic: za sprzęt płacimy raz, a wolumen przestaje być ograniczeniem finansowym. Więcej o platformie pokazuje nasze case study Policy Insider.
3.Wewnętrzny chatbot z RAG: dane, które zostają w firmie
Koszty i skala to jedna strona, kontrola nad danymi druga. Trzeci system służy naszemu zespołowi: to chatbot, który przeszukuje naszą wewnętrzną dokumentację i odpowiada na pytania. Zamiast przekopywać się przez dziesiątki dokumentów, zadajesz pytanie w języku naturalnym i dostajesz odpowiedź ze wskazaniem źródła. Rozwiązanie opiera się na wzorcu retrieval-augmented generation (RAG): system najpierw wyszukuje w naszych dokumentach pasujące fragmenty, a model buduje z nich odpowiedź, opierając się bardziej na nich niż na wiedzy z treningu.
System działa lokalnie na naszych własnych GPU, tym razem z modelem spoza rodziny Gemma: Qwen3 30B. Najwyraźniej widać tu zasadę, która łączy wszystkie trzy wdrożenia: skoro o modelu decyduje zadanie, nie ma powodu trzymać się jednej rodziny modeli. Qwen3 dobrze prowadzi rozmowę, radzi sobie z długimi dokumentami i mimo nominalnych 30 miliardów parametrów pozostaje szybki, bo każde zapytanie aktywuje tylko ich część (mixture-of-experts). Dzięki temu reaguje sprawnie także wtedy, gdy pyta wiele osób naraz, i przy każdej odpowiedzi może sięgać do dużych fragmentów dokumentacji.
Najważniejsze jest to, gdzie odbywa się przetwarzanie: nasza wiedza wewnętrzna, czyli projekty, oferty i know-how, nigdy nie trafia do zewnętrznego dostawcy. Dla nas to spokój. Dla klientów z sektorów regulowanych, takich jak finanse, ubezpieczenia, administracja publiczna czy ochrona zdrowia, może to być warunek, bez którego rozmowa o wdrożeniu AI w ogóle się nie zacznie.
Trzy systemy w skrócie
| System | Model | Co się liczy |
|---|---|---|
| Portal przetargowy | Gemma 4 26B z MTP | Czas odpowiedzi, 15 do 20 mln tokenów dziennie |
| Policy Insider | Gemma 4 31B | Dokładność, około 28 mln tokenów dziennie |
| Wewnętrzny chatbot | Qwen3 30B (MoE) | Dane zostają w firmie, wielu użytkowników naraz |
Ograniczenia i kompromisy
Lokalne modele LLM nie pasują do każdego przypadku. Warto znać ich ograniczenia:
- Koszt początkowy: sprzęt to inwestycja kapitałowa. Zwraca się przy odpowiednio dużym wolumenie i w wystarczająco długim okresie. Przy małej skali lub sporadycznym użyciu API w chmurze może wyjść taniej.
- Sprzęt jako górny pułap: model działa na własnych maszynach i jest ograniczony ich mocą obliczeniową, pamięcią i architekturą. Największych modeli może się po prostu nie dać uruchomić na danej konfiguracji. Z API w chmurze można natomiast korzystać nawet ze starego laptopa z dostępem do internetu, bo moc obliczeniowa leży po stronie dostawcy.
- Różnica jakości w najtrudniejszych zadaniach: przy złożonych problemach wymagających pogłębionego rozumowania czołowe modele komercyjne wciąż często dają lepsze wyniki. Nie każde zadanie wymaga jednak najwyższego poziomu rozumowania, więc dopasowanie modelu do zadania się opłaca.
- Bieżące utrzymanie: model trzeba hostować, monitorować i aktualizować. To stała odpowiedzialność operacyjna.
Jak uruchamiać LLM lokalnie: na co zwrócić uwagę
To, jak dobrze działa lokalne wdrożenie, zależy w równym stopniu od sposobu serwowania modelu, co od wyboru samego modelu. Kilka decyzji technicznych ma duży wpływ na koszty, jakość i szybkość.
- Kwantyzacja: wagi modelu można przechowywać z mniejszą precyzją, na przykład 8- lub 4-bitową zamiast domyślnej. To oszczędza pamięć GPU i zwykle przyspiesza inferencję. Im agresywniejsza kwantyzacja, tym większe oszczędności i tym większy możliwy spadek jakości. Celem jest poziom, na którym model działa szybciej i zajmuje mniej pamięci, a jakość pozostaje wystarczająca dla danego zadania. Dlatego każdy poziom weryfikujemy testami jakości na własnych danych.
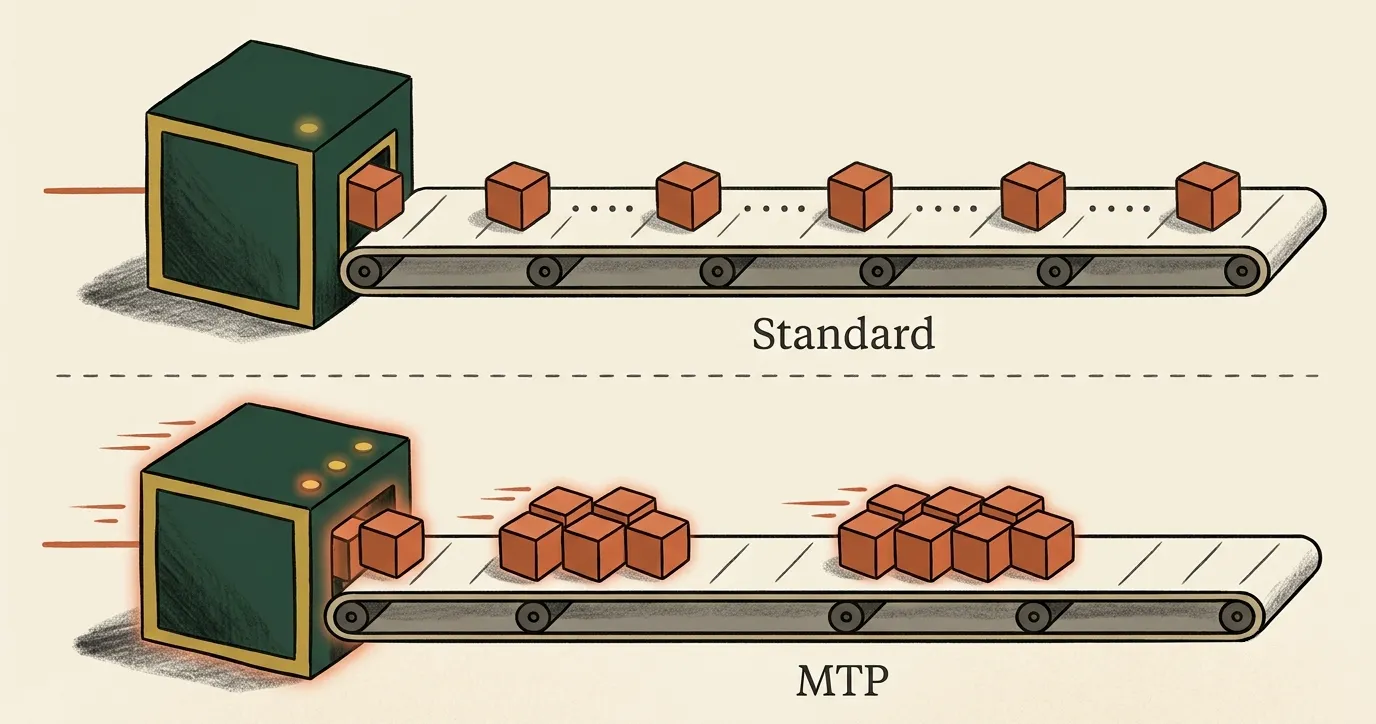
- Warstwa MTP (multi-token prediction): standardowy model generuje odpowiedź token po tokenie, co ogranicza jego szybkość. Warstwa MTP przewiduje kilka tokenów w jednym kroku i przyspiesza generowanie bez pogorszenia jakości. W naszym teście podniosła przepustowość modelu z portalu z około 72 do 88 tokenów na sekundę, a wariantu 31B z 16 do 40, czyli ponad dwukrotnie. MTP nie jest jednak dostępne dla każdego modelu, a warstwa nieznacznie zwiększa rozmiar modelu.
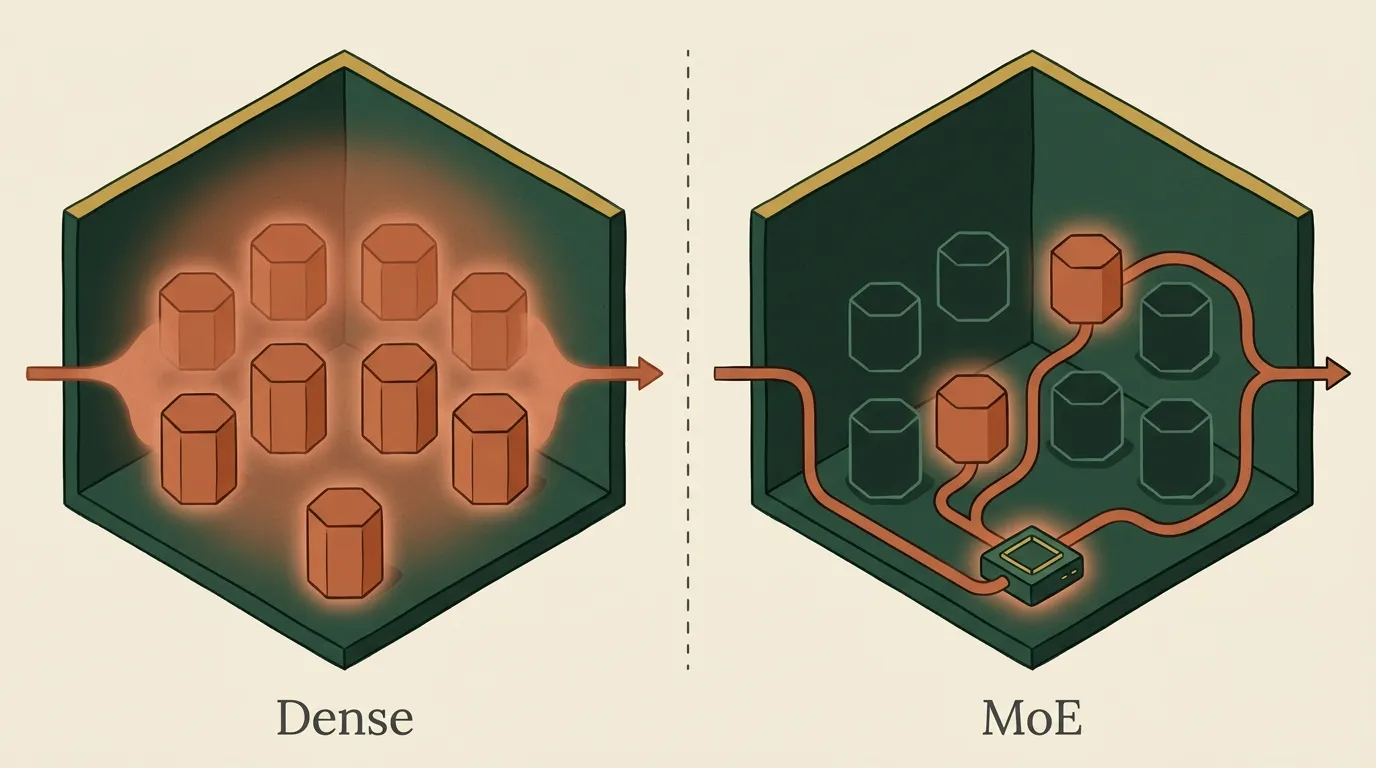
- Mixture-of-experts (MoE): model gęsty (dense) używa wszystkich parametrów dla każdego tokena. Model MoE jest podzielony na wiele wyspecjalizowanych podsieci, tzw. ekspertów, a niewielki router wybiera dla każdego tokena tylko kilku z nich. Na papierze model ma dziesiątki miliardów parametrów, ale zapytanie aktywuje tylko ich część. Dlatego model MoE działa znacznie szybciej i taniej niż model gęsty tej samej wielkości, a zachowuje większość jakości. Model w portalu przetargowym aktywuje przy zapytaniu tylko około 4 z 26 miliardów parametrów. Haczyk leży po stronie sprzętu: wszyscy eksperci i tak muszą zmieścić się w pamięci GPU.
- Okno kontekstowe i cache: im dłuższy tekst trafia do modelu, na przykład cały przetarg z załącznikami, tym więcej pamięci GPU zajmuje cache, w którym model przechowuje przetworzony już kontekst (KV cache). Ile kontekstu można realnie wykorzystać, zależy też od tego, ile pamięci zostaje po wczytaniu wag. Trzeba to zaplanować od początku.
- Oprogramowanie serwujące: stos serwujący decyduje o tym, jaką przepustowość daje ten sam sprzęt. vLLM i SGLang są zbudowane pod wysoką przepustowość i wiele równoległych zapytań i nadają się do zastosowań produkcyjnych. Ollama i llama.cpp są prostsze w konfiguracji i dobrze sprawdzają się w prototypach lub mniejszych wdrożeniach, ale pod obciążeniem tracą wydajność.
- Wiele równoległych zapytań: gdy z modelu korzysta jednocześnie wiele osób lub procesów, kluczowe jest grupowanie równoległych zapytań w efektywne partie (continuous batching). Dojrzałe oprogramowanie serwujące robi to automatycznie i dlatego ten sam sprzęt obsługuje kilka razy więcej zapytań niż przy przetwarzaniu czysto sekwencyjnym.
- Wybór sprzętu: wąskim gardłem jest zwykle pamięć GPU. Musi pomieścić wagi, okno kontekstowe i zapas na równoległe zapytania. Jeśli sprzęt można dobrać dowolnie, planowanie zaczyna się od obliczenia, ile pamięci potrzebuje wybrany model przy zakładanym poziomie kwantyzacji i spodziewanym obciążeniu.
Te decyzje są ze sobą powiązane. Kwantyzacja, stos serwujący i sprzęt wzajemnie na siebie oddziałują, a błąd w jednym miejscu zwykle objawia się słabą wydajnością w innym.
Kiedy model lokalny ma sens, a kiedy nie
Każdy z trzech systemów działa w warunkach, w których lokalne uruchomienie modelu jest lepszą opcją. Równie wiele przypadków przemawia jednak za API w chmurze.
Model lokalny ma zwykle sens, gdy
- dane nie mogą opuścić firmy: dane osobowe objęte RODO, dokumentacja medyczna, informacje finansowe, tajemnice przedsiębiorstwa czy dokumenty podlegające regulacjom branżowym (finanse, ubezpieczenia, ochrona zdrowia, administracja publiczna) często w ogóle nie mogą trafić do zewnętrznego dostawcy albo tylko z zabezpieczeniami, które wymagają więcej pracy niż uruchomienie modelu u siebie. W sektorach regulowanych wdrożenie lokalne jest często warunkiem realizacji projektu.
- wolumen jest duży i przewidywalny: przy milionach tokenów dziennie w powtarzalnym schemacie koszty API szybko przewyższają zamortyzowany koszt własnego sprzętu. Do tej grupy należą zarówno portal przetargowy, jak i Policy Insider.
- potrzebujesz pełnej kontroli nad modelem: dostrajanie na własnych danych, zamrożona wersja modelu, której zachowanie nie zmienia się po aktualizacjach u dostawcy, własne kwantyzacje czy niestandardowe konfiguracje serwowania są przy zamkniętym API niemożliwe albo mocno ograniczone.
API w chmurze ma zwykle sens, gdy
- wolumen jest mały lub nieprzewidywalny: przy sporadycznym użyciu zakup sprzętu nigdy nie zwróci się w porównaniu z opłatami za zapytania.
- potrzebujesz najwyższej jakości rozumowania: w najtrudniejszych zadaniach czołowe modele komercyjne wciąż mają przewagę. Jeśli o wartości całego systemu decyduje jakość odpowiedzi na najtrudniejsze zapytania, model w chmurze jest tam wart swojej ceny. Modele lokalne szybko jednak nadrabiają dystans, a dobrym przykładem jest Kimi K3.
- brakuje Ci ludzi do utrzymania: ktoś musi dbać o działanie GPU, aktualizować stos serwujący i reagować na incydenty. Bez takich kompetencji w firmie API jest najuczciwszym wyborem.
Kilka słów o bezpieczeństwie danych
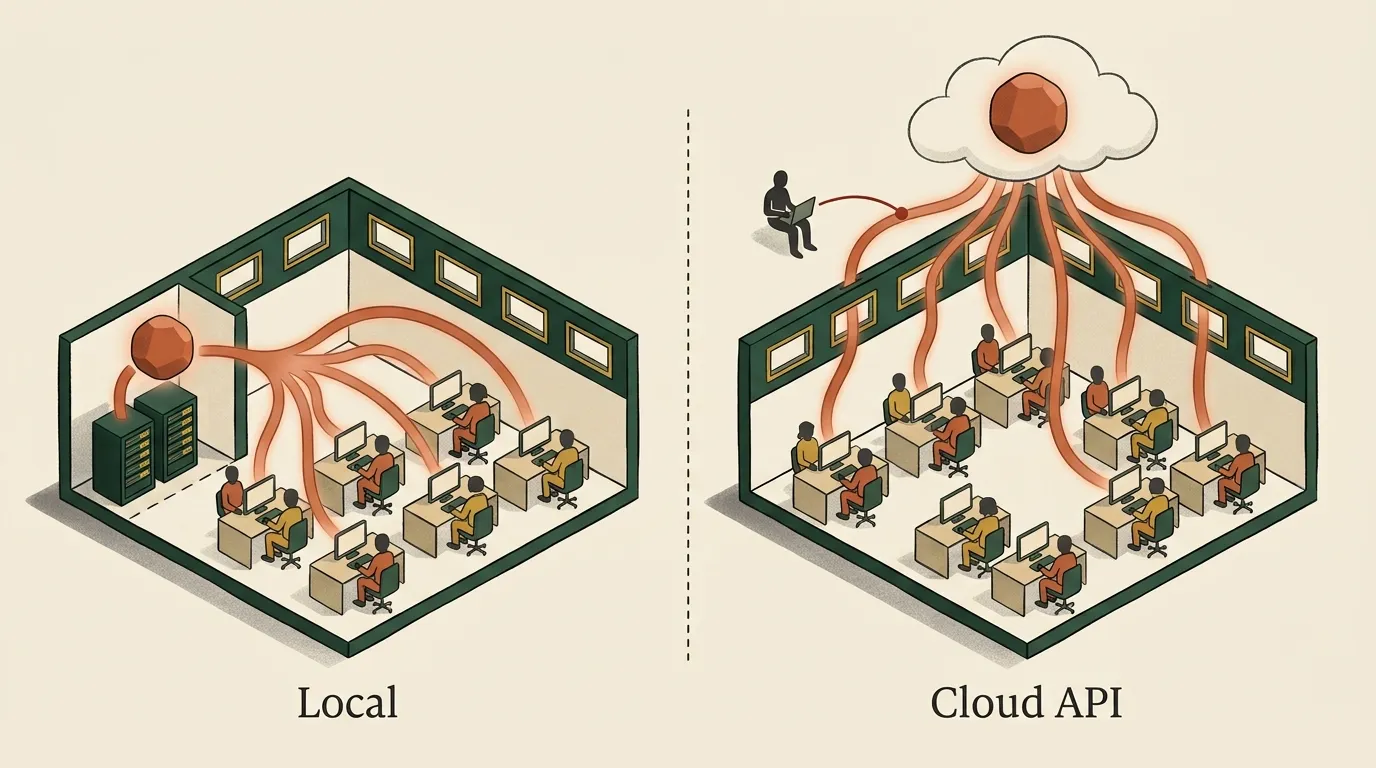
Argument bezpieczeństwa za modelami lokalnymi sięga dalej niż „dane nie opuszczają budynku”, a jednocześnie jest bardziej złożony.
Wdrożenie lokalne utrzymuje dane w infrastrukturze pod Twoją kontrolą, z Twoimi politykami dostępu, logowaniem i zasadami retencji. Nie ma regulaminów zewnętrznego dostawcy, które trzeba godzić z własnymi obowiązkami compliance, nie ma niepewności, czy zapytania zostaną później wykorzystane do trenowania, i nie ma zależności od poziomu zabezpieczeń dostawcy. W sektorach regulowanych skraca to często rozmowy o zgodności z miesięcy do dni.
Model na własnym sprzęcie nie jest jednak domyślnie bezpieczny. Jest bezpieczny tylko na tyle, na ile bezpieczne jest jego otoczenie. Dostęp musi być uwierzytelniany i logowany, prompty i odpowiedzi mogą zawierać dane wrażliwe, a systemy RAG dziedziczą uprawnienia repozytorium dokumentów: chatbot, który zaindeksuje pliki niedostępne dla danego użytkownika, bez wahania pokaże mu ich treść.
Model lokalny usuwa dużą kategorię ryzyka, czyli wypływ danych na zewnątrz, i zastępuje ją mniejszą, lepiej znaną: bezpieczeństwem aplikacji i infrastruktury. Dla większości organizacji to korzystna wymiana, pod warunkiem że tę drugą kategorię potraktują poważnie.
Podsumowanie: o lokalnym LLM decyduje zadanie
Lokalne modele LLM to długoterminowe zobowiązanie operacyjne. Tam, gdzie wolumen jest duży albo dane nie mogą opuścić firmy, są często rozwiązaniem bardziej ekonomicznym, a czasem jedynym dopuszczalnym. Sposób serwowania modelu ma przy tym takie samo znaczenie jak jego wybór.
W theBlue.ai wdrażamy lokalne modele LLM dla klientów i we własnej firmie. Z tych projektów wiemy, gdzie leżą prawdziwe kompromisy i kiedy właściwą odpowiedzią jest model lokalny, API w chmurze lub konfiguracja hybrydowa. Więcej znajdziesz na stronie Rozwój LLM.

Lokalnie czy w chmurze w Twoim przypadku?
W ramach warsztatu AI Discovery odpowiadamy na to pytanie w ciągu 1 do 3 tygodni i przekazujemy propozycję architektury, na podstawie której możesz działać.
Zapytaj o warsztatNajczęściej zadawane pytania
Lokalny LLM to model open source, na przykład z rodziny Gemma, Llama lub Qwen, który działa na Twoim własnym sprzęcie, a nie na serwerze zewnętrznego dostawcy. Dane nie opuszczają firmy i nie ma opłaty za każde zapytanie.
Gdy dane nie mogą opuścić firmy, gdy wolumen jest duży i przewidywalny, np. miliony tokenów dziennie, albo gdy potrzebujesz pełnej kontroli nad modelem. Przy małym lub zmiennym wolumenie, najwyższych wymaganiach co do rozumowania albo braku ludzi do utrzymania lepsze jest zwykle API w chmurze.
Nasz portal przetargowy przetwarza 15 do 20 milionów tokenów dziennie, czyli 5,5 do 7,3 miliarda rocznie. Przez GPT-5 kosztowałoby to 6875 do 9125 USD wyłącznie za tokeny wejściowe, według cennika OpenAI z lipca 2026. Lokalnie za sprzęt płaci się raz.
Nie. Usuwa ryzyko wypływu danych na zewnątrz, ale jest bezpieczny tylko na tyle, na ile bezpieczne jest jego otoczenie. Dostęp musi być uwierzytelniany i logowany, a systemy RAG dziedziczą uprawnienia repozytorium dokumentów.
Aleksandra od 2021 roku tworzy w theBlue.ai dedykowane rozwiązania AI. Specjalizuje się w systemach agentowych i wdrożeniach lokalnych modeli LLM dopasowanych do potrzeb firm. Jako AI Engineer pomaga organizacjom automatyzować procesy za pomocą systemów gotowych do pracy produkcyjnej: od modeli open source działających on-premise po wewnętrzne bazy wiedzy oparte na RAG dla branż regulowanych. Na bieżąco poszerza swoją wiedzę w szybko zmieniającym się świecie sztucznej inteligencji.
W swoich artykułach dzieli się doświadczeniem z prawdziwych projektów enterprise AI i pokazuje, że wdrożenie AI w firmie nie musi być skomplikowane.