
News & Events · ML Con
Von Sprachassistenten zu lernenden Systemen: Rückblick auf die ML Con New York
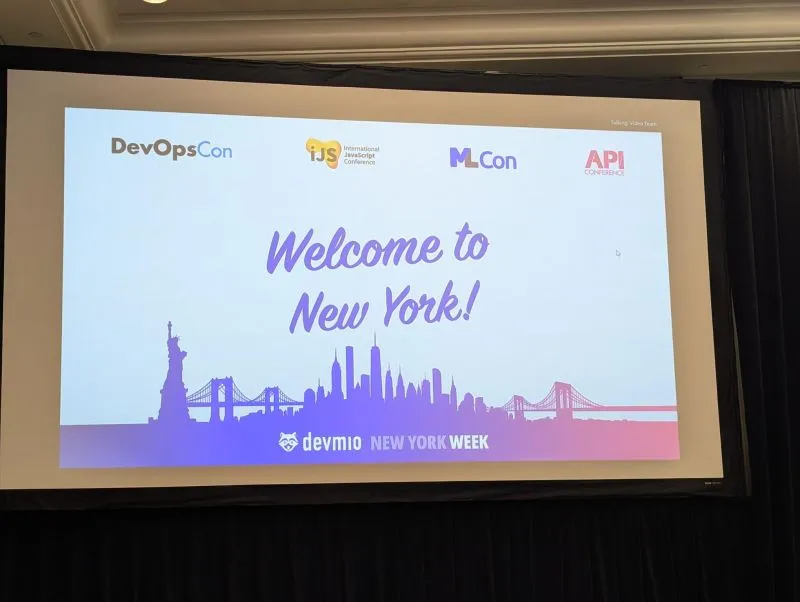
Vier Konferenzen unter einem Dach, ein dicht gefüllter Nachmittag und zwei sehr verschiedene Anwendungen von KI. Agata Chudzińska, CTO von theBlue.ai, hielt im September zwei Vorträge auf der ML Con by devmio im New York Marriott at the Brooklyn Bridge. Beide laufen auf dieselbe Frage hinaus: Wie bringt man ein KI-System von der Vorführung in den täglichen Betrieb, wo es schnell, verlässlich und anpassungsfähig arbeiten muss?
 Julia Rose
Das Wichtigste in Kürze
- Am 29. September 2026 hielt Agata Chudzińska zwei Vorträge hintereinander auf der ML Con in New York, im New York Marriott at the Brooklyn Bridge.
- Vortrag eins behandelte Verzögerungen in Sprachassistenten: wo sie entstehen und warum Durchschnittswerte das Problem verdecken.
- Vortrag zwei zeigte an einem Fall aus der MRT-Diagnostik, wie ein Modell mit neuen Daten weiterlernt, ohne das Alte zu vergessen.
- Beide Themen führen zu derselben Folgerung: Anpassungsfähigkeit ist eine Entscheidung beim Entwurf, nicht etwas, das man später ergänzt.
Vortrag 1: Voice Agents, Where Latency Hides and How to Fight It
Textbasierte KI-Agenten dürfen eine gewisse Trägheit haben. Für sprachbasierte Systeme gilt ein anderer Maßstab. Zwischen zwei Menschen im Gespräch liegen im Mittel 208 Millisekunden, gemessen über zehn Sprachen auf fünf Kontinenten. Wer mit einer Maschine spricht, erwartet denselben Takt. In der Praxis verstecken sich Verzögerungen aber in jeder einzelnen Schicht des Systems.
Der Vortrag sortierte sie in drei Baustellen.
- Das Ende des Redebeitrags erkennen. Stille bedeutet nicht Satzende. Ob jemand nachdenkt, eine Zahlenfolge vorliest oder sich selbst korrigiert („Ich möchte zur, ähm, Penn Station, nein, Grand Central“): Ein einfacher Zeitgeber auf Basis von Stille greift zu kurz. Heutige Verfahren setzen auf Modelle, die aus Satzbau und Sprechmelodie vorhersagen, ob ein Gedanke zu Ende ist.
- Den richtigen Übertragungsweg wählen. Klassisches HTTP über TCP bringt für ein Gespräch zu viel Verwaltungsaufwand mit. Für Echtzeit gilt heute: WebRTC auf der ersten Strecke zwischen Gerät und eigener Infrastruktur, WebSocket zwischen den eigenen Diensten, SIP fürs Telefonnetz.
- Unterbrechungen. Wenn der Anrufer ins Wort fällt, reicht es nicht, die Sprachausgabe zu stoppen. Das System muss den Gesprächsverlauf auf das kürzen, was der Anrufer tatsächlich gehört hat. Sonst beruft es sich später auf Sätze, die nie bei ihm angekommen sind.
Die Kernaussage betraf die Messung. Wer Sprachassistenten baut, sollte sich nicht auf Durchschnittswerte verlassen, und auch nicht auf den Median allein. Entscheidend ist das obere Ende der Verteilung. Eine Plattformmessung vom August 2026 kam im besten Fall auf 1,73 Sekunden im Median, bei 3,19 Sekunden für jeden zwanzigsten und 10,4 Sekunden für jeden hundertsten Wortwechsel. Ist nur jeder zwanzigste Wortwechsel langsam, erleben bei zwanzig Wechseln pro Gespräch 64 von 100 Anrufern mindestens eine lange Pause.
Vortrag 2: Building AI That Learns and Adapts
Während Sprachassistenten auf Millisekunden hin optimiert werden, kämpfen medizinische KI-Systeme mit einem grundlegenderen Problem des maschinellen Lernens: dem katastrophalen Vergessen.
Als Beispiel diente ein Fall aus der Epileptologie, die Erkennung fokaler kortikaler Dysplasien im MRT. Die Forschung dazu leitete Dr. Patrick House am größten Epilepsie-Zentrum Deutschlands. Der Vortrag zeigte daran, wie ein neuronales Netz sich an veränderte Datenverteilungen anpassen kann, ohne zu verlieren, was es vorher konnte.
Wird ein Modell mit neuen Daten aktualisiert, etwa nach einem Gerätewechsel oder bei neuen Befundarten, versagt es nach einem naiven Nachtraining oft bei den alten Fällen. Der naheliegende Ausweg, alles von vorn zu trainieren, stößt in Projekten dieser Art an zwei Grenzen. Erstens müssen dafür alle alten Daten noch vorhanden sein, was bei Patientendaten selten dauerhaft möglich ist. Zweitens kostet jeder vollständige Durchlauf dieselbe Rechenzeit wie der erste, mit entsprechendem Energieverbrauch.
Unter dem Namen Continual Learning sammelt die Forschung die Gegenmittel, und auffällig viele davon sind der Funktionsweise des Gehirns abgeschaut. Verfahren mit Regularisierung, etwa Elastic Weight Consolidation, bestimmen die Parameter, die für die alte Aufgabe wichtig waren, und schützen sie vor Veränderung. Verfahren mit Wiedervorlage halten eine kleine Auswahl alter Beispiele vor und trainieren sie immer wieder mit. Im MRT-Projekt blieb die Sensitivität auf demselben Niveau, während die Spezifität deutlich stieg.
Zum Schluss der Blick nach vorn: Bei großen Sprachmodellen ist dasselbe Problem ungelöst, weil ein solches Modell in mehreren Stufen entsteht und jede Stufe überschreiben kann, was die vorige gelernt hat. Der weitestgehende Vorschlag stammt derzeit von Google Research und heißt Nested Learning. Dabei besteht das Training aus mehreren ineinander verschachtelten Schleifen, von denen einige schnell laufen und sich anpassen, während andere langsam laufen und festigen, was Bestand haben soll. Auch das ist dem Gehirn abgeschaut.
Den MRT-Fall haben wir ausführlich beschrieben, mit Aufbau, beiden Modellfassungen und den klinischen Ergebnissen, in KI, die lernt und sich anpasst.
Der gemeinsame Nenner: Anpassungsfähigkeit als Entwurfsentscheidung
Ob im Millisekundenbereich bei Sprachassistenten oder über Monate der Validierung bei medizinischen Bilddaten: Die Lehre aus New York ist in beiden Fällen dieselbe. Anpassungsfähigkeit lässt sich nicht nachrüsten, sie wird beim Entwurf entschieden.
Moderne KI-Systeme müssen von Anfang an damit umgehen können, dass sich Rahmenbedingungen verschieben, dass neue Daten anders aussehen als die alten und dass die Antwort in einer bestimmten Zeit da sein muss. Dass in New York vier Konferenzen zusammenliefen, Machine Learning, DevOps, API und JavaScript, passt dazu. Die Verbindung von hardwarenaher Technik und maschinellem Lernen ist genau die Stelle, an der zurzeit die interessanten Fragen liegen.
Wie wir solche Vorhaben zuschneiden, steht auf der Seite So arbeiten wir. Mehr über das Team lesen Sie auf Über uns.
Die Zahlen stammen aus den Präsentationen und tragen dort ihre Quellen: Stivers et al., PNAS 106(26), 2009, für den menschlichen Gesprächstakt, eine Plattformmessung von Cekura vom August 2026 für die Antwortzeiten, van de Ven et al., 2024, für das katastrophale Vergessen und Google Research für Nested Learning. Zur Veranstaltung: ML Con by devmio.

Sie planen ein KI-Projekt?
In der Prozessanalyse nehmen wir Ihre Abläufe auf, sortieren die möglichen Anwendungsfälle nach Nutzen und schlagen eine Architektur vor.
Prozessanalyse anfragenHäufige Fragen
Über zwei Themen. Der erste Vortrag am 29. September 2026 hieß „Voice Agents: Where Latency Hides and How to Fight It“ und behandelte Verzögerungen in Sprachassistenten. Der zweite, „Building AI That Learns and Adapts“, zeigte an einem Fall aus der MRT-Diagnostik, wie ein Modell mit neuen Daten weiterlernt.
Weil Stille im Gespräch als Störung gelesen wird. Zwischen zwei Menschen liegen im Mittel 208 Millisekunden zwischen Frage und Antwort. Bei einem Chatfenster sieht der Nutzer, dass etwas passiert, am Telefon hört er nur nichts.
Katastrophales Vergessen beschreibt den Effekt, dass ein neuronales Netz beim Nachtrainieren auf neue Daten verliert, was es vorher konnte. In der Medizin tritt das etwa auf, wenn ein Modell nach einem Gerätewechsel mit neuen Aufnahmen aktualisiert wird.
Continual Learning bezeichnet Verfahren, mit denen ein Modell schrittweise dazulernt, ohne das Vorherige zu verlieren. Dazu gehören Regularisierung, etwa Elastic Weight Consolidation, und das Wiedervorlegen alter Beispiele aus einem kleinen Speicher. Viele dieser Verfahren sind der Funktionsweise des Gehirns nachempfunden.
Die ML Con ist eine Konferenz für Machine Learning und generative KI, veranstaltet von devmio. Die Ausgabe in New York fand Ende September 2026 im New York Marriott at the Brooklyn Bridge statt, gemeinsam mit drei weiteren Konferenzen zu DevOps, APIs und JavaScript.
Julia ist seit 2019 Teil von theBlue.ai und begleitet die Entwicklung von KI-Anwendungen im Unternehmensumfeld seit den frühen Tagen des Unternehmens. In ihrer Rolle als Marketing Lead arbeitet sie eng mit den Engineering- und Consulting-Teams zusammen und macht komplexe technische Themen für Entscheider verständlich und zugänglich.
In ihren Artikeln schreibt sie über praktische Erfahrungen aus Enterprise-KI-Projekten sowie über die Herausforderungen und Chancen beim Einsatz von KI in Unternehmen.