LLMs & KI-Agenten · Multi-Agenten
Fünf Agenten, ein Orchestrator, 70 Prozent weniger Routinearbeit
Warum der Prozess die Architektur von KI-Agenten bestimmt. Was ein Agent grundsätzlich kann, ist kein Geheimnis mehr: recherchieren, Dokumente auswerten, Systeme bedienen, Antworten formulieren. Schwieriger ist die Frage, welche dieser Fähigkeiten sich im eigenen Unternehmen in produktive Arbeit übersetzen lassen.
 Julia Rose
Das Wichtigste in Kürze
- Ein LLM, das an eine bestehende Anwendung angebunden wird, ist noch kein Enterprise-Agent. Zuverlässigkeit, Nachvollziehbarkeit und Kontrolle zählen mehr als Autonomie.
- Die Prozessanalyse kommt vor der Modell- und Agentenauswahl. Manche Schritte bleiben besser deterministisch.
- Bei der RPP Group übernehmen fünf spezialisierte Agenten unter einem Orchestrator so viel Routinearbeit, dass der Zeitaufwand dafür um rund 70 % sank.
- Datenzugriff, Governance und Legacy-Integration gehören von Anfang an in die Architektur.
- Custom heißt, für jeden Teil des Problems die passende Abstraktionsebene zu wählen, vom zugekauften Modell bis zur eigenen Orchestrierung.
In einer Demo wirkt ein KI-Agent schnell souverän. Er bekommt eine Aufgabe, greift auf Informationen zu, führt Aktionen aus und liefert genau das Ergebnis, das man sehen möchte. Auch ein Proof of Concept kann überzeugend zeigen, dass eine Idee technisch funktioniert. Ob daraus im Unternehmensbetrieb ein verlässliches Arbeitssystem wird, ist damit noch offen.
Dort trifft das Modell auf gewachsene Prozesse, Berechtigungslogiken, Legacy-Landschaften, Compliance-Vorgaben und unzählige undokumentierte Ausnahmen, die trotzdem jeden Tag greifen. An dieser Reibung entscheidet sich, ob ein Agent produktiv wird oder nach dem Pilotprojekt in der Schublade verschwindet.
Bevor also die Frage kommt, welchen Agenten man einsetzt, muss eine unbequemere geklärt sein: Welche konkrete Arbeit soll ein KI-System übernehmen, unter welchen Bedingungen, mit welchem Wissen im Hintergrund und mit welcher Verantwortung? „KI-Agent“ ist für uns dabei die übergeordnete Kategorie. Je nach Prozess entsteht daraus ein einzelner Agent, ein Multi-Agenten-System oder eine Kombination aus KI, klassischer Software und menschlichen Freigaben. Die Architektur folgt dem Prozess.
Warum ein LLM noch kein Enterprise-Agent ist
Zu den häufigen Fehlern bei KI-Initiativen gehört der Reflex, eine bestehende Anwendung um ein Sprachmodell zu erweitern und das Ergebnis Agent zu nennen. Ein Dokument geht an ein LLM, das Modell liefert eine Zusammenfassung, dazu vielleicht ein RAG-Layer und ein paar API-Aufrufe. Für einen Proof of Concept reicht das oft. Ein Unternehmenssystem muss aber jeden Tag zuverlässig mit der Realität umgehen: unterschiedlichen Eingaben, wechselnden Zuständigkeiten, Ausnahmen und Abhängigkeiten zu anderen Systemen.
Ein produktiver Agent muss deshalb erkennen, welche Information gerade relevant ist, welcher Schritt als Nächstes ansteht, welche Komponente zuständig ist, welche Daten er verwenden darf und wann ein Mensch übernimmt. Dazu kommen Fragen, die in Demos selten auftauchen:
- Wie wird der Zustand eines Vorgangs über mehrere Schritte gehalten?
- Was passiert, wenn ein System nicht erreichbar ist oder ein Agent eine Aufgabe nicht zuverlässig lösen kann?
- Wie werden Berechtigungen durchgesetzt?
- Wie lässt sich nachvollziehen, warum das System eine Entscheidung getroffen hat?
Das LLM ist nur eine von mehreren Komponenten. Den Unterschied zwischen einem einfachen GPT-Wrapper und einer maßgeschneiderten Agentenarchitektur macht die Systemlogik um das Modell herum: Orchestrierung, Zuständigkeiten, Kontrollmechanismen und Übergaben an andere Systeme oder Menschen. Ein Enterprise-Agent muss vor allem zuverlässig, nachvollziehbar und kontrollierbar arbeiten. Das ist eine andere Designaufgabe als die Optimierung von Modellantworten.
Prozessanalyse vor Prompt Engineering
Unser erster Schritt ist deshalb eine ausführliche Analyse des Prozesses. Was passiert dort im Alltag tatsächlich? Wer sucht welche Informationen zusammen, welche Systeme werden geöffnet, und wer entscheidet an welcher Stelle? Was ist dokumentiert, und was existiert nur als Erfahrungswissen einzelner Mitarbeitender? Und vor allem: Welche Teile lassen sich sinnvoll mit einem probabilistischen System automatisieren, und welche bleiben besser in deterministischer Logik?
Dieser letzte Punkt wird oft unterschätzt, denn nicht jeder Prozessschritt braucht ein LLM:
| Aufgabe im Prozess | Passendes Werkzeug |
|---|---|
| Klar definierte Ableitung | Deterministische Regel: schneller, günstiger, nachvollziehbarer |
| Zugriff auf bekanntes Wissen | Retrieval |
| Strukturierte Extraktion aus PDFs | Oft klassische Dokumentenverarbeitung |
| Informationen bewerten, Schritte verknüpfen, freie Eingaben deuten | KI-Agent |
Aus dieser Aufteilung entsteht die Architektur. Erst wenn klar ist, welches Werkzeug welche Aufgabe am besten erfüllt, lässt sich entscheiden, wo ein Agent gebraucht wird, wo klassische Software reicht und wo ein Mensch die Verantwortung trägt. Die Frage lautet dann: Wie modelliere ich diesen Arbeitsprozess als System, in dem Menschen, Software und KI sinnvoll zusammenarbeiten? Ein einzelner Agent kann dabei mehrere Tools nutzen, und ein komplexer Prozess kann mehrere spezialisierte Agenten erfordern. Entscheidend ist, dass die Architektur den Prozess zuverlässig abbildet und die Verantwortlichkeiten klar sind. Wie wir diese Analyse angehen, beschreibt unsere Seite So arbeiten wir.
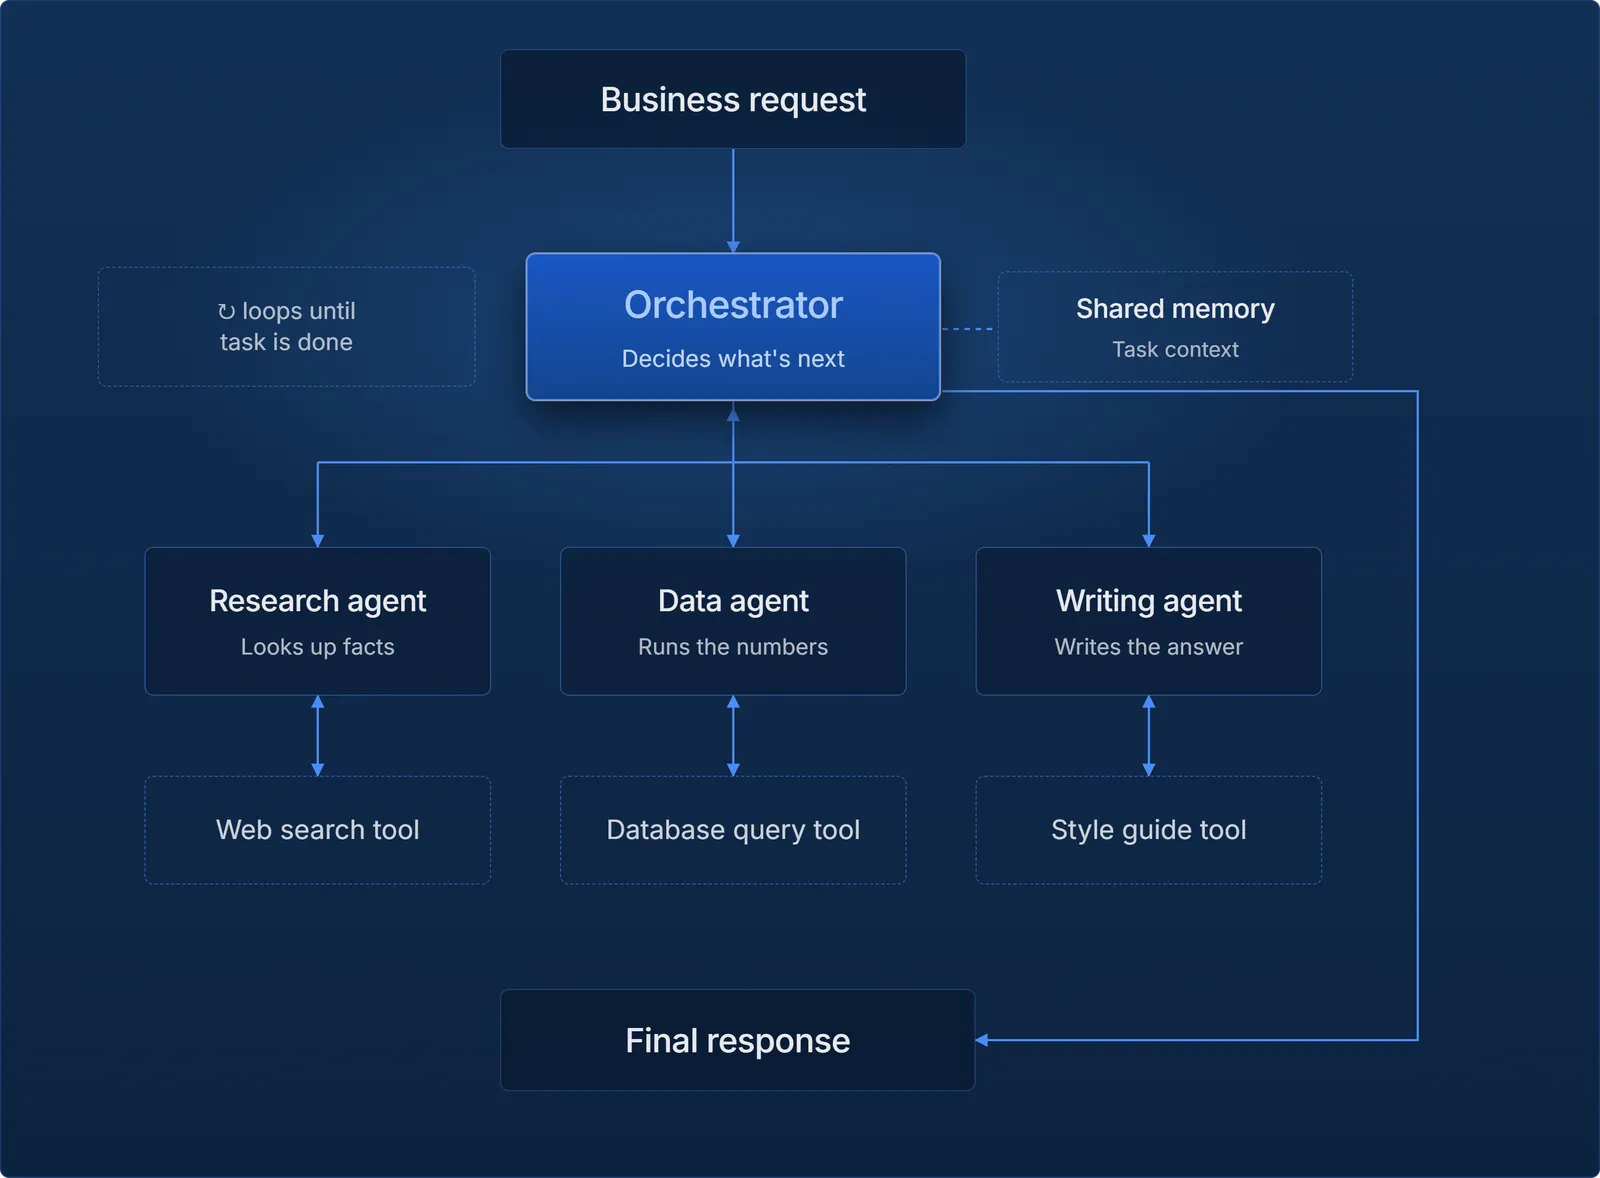
Über den Erfolg entscheidet die Systemlogik um das Modell herum. Ein Enterprise-Agent muss zuverlässig, nachvollziehbar und kontrollierbar arbeiten.
Ein reales Beispiel: fünf Agenten für einen Geschäftsprozess
Die RPP Group arbeitet an der Schnittstelle von Policy, Politik und Kommunikation. Zugang zu einem leistungsfähigen LLM war für das Haus nie das Problem. Das eigentliche Problem: Hochqualifizierte Analysten verbrachten viel Zeit mit vorhersehbarer, wiederkehrender Arbeit, etwa umfangreiche Dokumente analysieren, Policy-Informationen strukturieren und Kommunikationsmaterial vorbereiten. Diese Aufgaben verlangen Fachverständnis und folgen trotzdem wiederkehrenden Mustern. Genau das machte sie zu guten Kandidaten für eine systematische Automatisierung.
Policy-Dokumente umfassen oft hundert Seiten und mehr. Inhalte müssen extrahiert, strukturiert, abgeglichen und in einen kommunizierbaren Kontext gebracht werden. Dazu kam eine harte Randbedingung, die viele Standardlösungen ausschließt: Vertrauliche politische Dokumente dürfen nicht auf einer beliebigen externen Cloud verarbeitet werden.
Ein einzelner Chatbot hätte das nur teilweise abbilden können. So entstand gemeinsam mit Policy-Insider.AI ChatRPP, ein Multi-Agenten-System mit fünf spezialisierten Agenten, einem Orchestrator und der bestehenden Infrastruktur der RPP Group. Die Zahl fünf hat sich aus der Arbeitsteilung ergeben. Der Orchestrator leitet jede Anfrage an den passenden Spezialisten weiter, etwa für Dokumentenanalyse, Entwürfe, strategische Planung oder Policy-Recherche, und stellt den nötigen Kontext und die passenden Werkzeuge bereit. Eigene QA-Agenten prüfen die Ergebnisse gegen interne Standards.
Aus der Praxis: ChatRPP
Bei der RPP Group sank der Zeitaufwand für manuelle Routinearbeit um rund 70 %. Die Verarbeitung ist DSGVO-konform und läuft in der eigenen Infrastruktur, vertrauliche Informationen verlassen die kontrollierte Umgebung nicht.
Warum Spezialisierung in Multi-Agenten-Systemen zählt
Je komplexer ein Prozess, desto genauer sollte geprüft werden, ob ein einzelner universeller Agent die passende Architektur ist. Ein System, das Dokumente analysiert, im Web recherchiert, interne Daten interpretiert, Inhalte formuliert, Compliance-Regeln einhält und Ergebnisse kontrolliert, lässt sich technisch als ein Agent bauen. Brauchen die Aufgaben aber unterschiedliche Kontexte, Werkzeuge, Berechtigungen oder Kontrollen, ist eine Aufteilung auf spezialisierte Agenten oft sinnvoller. Multi-Agent ist eine mögliche Architekturentscheidung unter mehreren.
Spezialisierte Agenten trennen Aufgaben und Verantwortlichkeiten sauber. Der Orchestrator koordiniert, die Spezialisten übernehmen klar definierte Schritte, Datenquellen werden kontrolliert eingebunden, und Zwischenergebnisse lassen sich unterwegs prüfen, ergänzen oder verwerfen. Qualität bemisst sich dann weniger am Benchmark eines einzelnen LLM als daran, wie robust die ganze Kette aus Routing, Retrieval, Verarbeitung, Generierung und Kontrolle im Alltag trägt.
Bei ChatRPP haben wir dafür Multi-Agenten-Orchestrierung, mehrere LLMs, RAG, Dokumentenverarbeitung und klassische Python-Logik kombiniert, den Fachdienst Policy-Insider.AI integriert und alles in einer DSGVO-konformen Infrastruktur betrieben. Produktiv läuft also eine individuelle KI-Architektur, in der spezialisierte Agenten mit klassischer Software, Datenquellen und Governance zusammenspielen. Mehr zu Architekturmustern, Protokollen und Governance steht in unserem Artikel Multi-Agent Systeme.
Die Datenfrage gehört in die Architektur
In Demos wird Integration gern als Komfortfunktion gezeigt: Der Agent verbindet sich mit Slack, CRM, Kalender und Dokumentenablage. Im Unternehmen ist Zugriff fast immer eine Governance-Frage. Was darf ein Agent lesen? Welche Informationen darf er über Systemgrenzen hinweg verknüpfen? Was darf er selbst verändern, und was legt er einem Menschen zur Freigabe vor? Und wie wird protokolliert, wer wann was ausgelöst hat, damit ein Ergebnis auch Wochen später nachvollziehbar bleibt?
Diese Fragen gehören von Anfang an in die Konstruktion. Agenten arbeiten innerhalb definierter Berechtigungen, pausieren bei sensiblen Aktionen, warten auf Freigaben und tun im Zweifel lieber zu wenig als zu viel. Ein generisches Governance-Modell reicht dafür selten: Ein Agent, der einen Blog-Entwurf schreibt, braucht eine andere Freigabelogik als einer, der mit vertraulichen Finanzdaten arbeitet oder Datensätze in einem produktiven System ändert. Individuelle Architektur bedeutet deshalb auch individuelle Governance.
Legacy-Integration ist der eigentliche Architekturtest
Demos funktionieren am besten, wo alle Systeme saubere APIs haben. Im Unternehmen liegen Daten dagegen in vielen Anwendungen, manche modern und dokumentiert, andere über zehn oder fünfzehn Jahre gewachsen und nur noch von wenigen Menschen im Haus verstanden. Berechtigungsmodelle passen selten zusammen, und ein guter Teil der Prozessarbeit läuft noch über E-Mails, Excel-Anhänge und manuelle Übergaben. An diesen Nahtstellen zeigt sich, ob ein Agent tatsächlich Arbeit übernimmt.
Eine maßgeschneiderte Lösung muss deshalb viel mehr klären als die Ausgabe des Modells:
- Welches System ist für welche Information die führende Quelle?
- Wann muss eine Information live abgerufen werden, und wann darf sie zwischengespeichert sein?
- Wie wird der Zustand eines mehrstufigen Prozesses gehalten?
- Was passiert bei widersprüchlichen Angaben oder einem fehlgeschlagenen Tool-Aufruf, und welche Schritte lassen sich rückgängig machen?
- Wo wird ein Mensch eingebunden, und welche Aktionen müssen auditierbar sein?
Das sind klassische Architekturfragen. Neu ist, dass sie sich heute in probabilistischen Systemen stellen, deren Verhalten sich nicht mehr vollständig in einer Wahrheitstabelle abbilden lässt. Im AI-Engineering reicht es deshalb nicht, Schnittstellen zu verbinden. Man muss auch festlegen, wie ein System mit Unsicherheit, Fehlern und Entscheidungen umgeht. Wie die Anbindung an SAP, Microsoft 365 und Jira konkret aussieht, zeigt unser Artikel KI integrieren in SAP, Microsoft 365 und Jira.
Der wirtschaftliche Wert liegt in gewonnener Kapazität
Bei der RPP Group war das Ziel nie, mit besonders beeindruckenden Antworten zu glänzen. Senior-Analysten sollten von Arbeit entlastet werden, die Zeit frisst, ihre Expertise aber nicht braucht. Die Referenz beziffert das mit rund 70 % weniger Zeitaufwand für routinemäßige manuelle Aufgaben, und die Ergebnisse fließen direkt in die täglichen Abläufe der Analysten.
Das ist eine andere Metrik als die LLM-Benchmarks der Fachpresse. Ob ein Modell auf MMLU zwei Prozentpunkte besser oder schlechter abschneidet, ist für eine CTO oder einen CTO zweitrangig. Interessant wird es, wenn sich ein realer Geschäftsprozess strukturell verändert. Weniger Routine bedeutet gewonnene Kapazität, und die investiert die RPP Group jetzt in strategische und kundennahe Arbeit.
Custom heißt, die richtige Abstraktionsebene zu wählen
„Custom AI“ wird manchmal so verstanden, als würde für jedes Unternehmen ein eigenes Foundation Model trainiert. Unser Ansatz meint etwas anderes: die Freiheit, für jedes Problem die passende Abstraktionsebene zu wählen. Das Basismodell darf von einem externen Anbieter kommen, RAG ist oft die pragmatische Wahl, bestehende APIs bleiben in Betrieb, und fertige Komponenten für Dokumentenverarbeitung oder Orchestrierung kommen zum Einsatz, wenn sie passen. Maßgeschneidert wird die Lösung dort, wo diese Bausteine zu einem System zusammengesetzt werden, das genau die Prozesse des Hauses abbildet.
Die Ingenieursarbeit steckt entsprechend in Prozessdesign, Systemarchitektur, Orchestrierung, Datenzugriff, Zustandsverwaltung, Governance, Integration in die IT-Landschaft und, oft am meisten unterschätzt, in der Evaluation. Die Prozessanalyse ist deshalb ein eigener Schritt. Sie entscheidet, was gebaut werden sollte, und in vielen Fällen auch, was sich nicht lohnt.
Vom Feature zur Infrastruktur
Wenn Unternehmen individuelle KI-Systeme in reale Prozesse einbinden, entsteht eine neue Ebene zwischen Menschen und Unternehmenssoftware. ERP, CRM, DMS, Collaboration-Tools und Datenbanken laufen weiter, darüber entsteht eine Prozessschicht, die Informationen zwischen diesen Systemen bewegt und Aufgaben über Anwendungen hinweg koordiniert.
Standardisierte Agenten sind für viele generische Aufgaben eine gute Wahl. Kommen unternehmensspezifisches Wissen, eigene Prozesse, sensible Daten und eine gewachsene Systemlandschaft zusammen, wird eine individuell entworfene Lösung zum Hebel. Nicht jeder Prozess braucht dafür fünf Agenten, und manche brauchen gar keinen:
- Manches bleibt deterministisch, weil ein probabilistisches System dort keinen Nutzen bringt.
- Anderes profitiert von einem einzelnen, klar abgegrenzten KI-Schritt in einer sonst konventionellen Anwendung.
- Wieder andere Prozesse entfalten ihr Potenzial erst, wenn mehrere spezialisierte Agenten unter einem Orchestrator zusammenarbeiten.
Die entscheidende Kompetenz ist, für jeden Prozess ehrlich zu bewerten, welche dieser Architekturen dem Unternehmen am meisten bringt. Genau damit beginnt jede Zusammenarbeit mit theBlue.ai: mit einer Analyse, wie die Arbeit tatsächlich läuft, welche Entscheidungen getroffen werden, welche Systeme beteiligt sind und wo menschliche Expertise unverzichtbar bleibt. Mehr dazu auf unserer Seite zur Multi-Agenten-Entwicklung.
Welcher Prozess eignet sich für KI-Agenten?
In der Prozessanalyse prüfen wir mit Ihnen, wo KI tatsächlich Arbeit abnehmen kann, ob ein einzelner Agent, ein Multi-Agenten-System oder eine andere Architektur passt und wo sich Automatisierung wirtschaftlich lohnt.
Prozessanalyse anfragenHäufige Fragen
Die Systemlogik um das Modell: Orchestrierung, Zustandsverwaltung, Berechtigungen, Fehlerbehandlung, Nachvollziehbarkeit und klare Übergaben an Menschen. Ein Enterprise-Agent muss vor allem zuverlässig und kontrollierbar arbeiten.
Wenn die Aufgaben unterschiedliche Kontexte, Werkzeuge, Berechtigungen oder Kontrollen verlangen. Viele Prozesse kommen mit einem Agenten oder einem einzelnen KI-Schritt aus, manche brauchen gar keinen.
Er nimmt die Anfrage an, leitet sie an den passenden spezialisierten Agenten weiter, stellt Kontext und Werkzeuge bereit und entscheidet, was als Nächstes passiert, bis die Aufgabe erledigt ist.
In der Regel nicht. Das Basismodell kommt oft von einem externen Anbieter. Maßgeschneidert sind Prozessdesign, Architektur, Orchestrierung, Datenzugriff, Governance und Integration.
Julia ist seit 2019 Teil von theBlue.ai und begleitet die Entwicklung von KI-Anwendungen im Unternehmensumfeld seit den frühen Tagen des Unternehmens. In ihrer Rolle als Marketing Lead arbeitet sie eng mit den Engineering- und Consulting-Teams zusammen und macht komplexe technische Themen für Entscheider verständlich und zugänglich.
In ihren Artikeln schreibt sie über praktische Erfahrungen aus Enterprise-KI-Projekten sowie über die Herausforderungen und Chancen beim Einsatz von KI in Unternehmen.