Computer Vision · Segmentierung
Zero-Shot-Bildsegmentierung: Objekte erkennen ohne große Trainingsdaten
Klassische Bildsegmentierung braucht Tausende handbeschriftete Beispiele pro Objektklasse. Zero-Shot-Modelle segmentieren auch Objekte, die sie im Training nie gesehen haben. Für Medizintechnik und Qualitätsprüfung heißt das vor allem: schneller zu Trainingsdaten und Prototypen.
 Aleksandra Osztynowicz
Das Wichtigste in Kürze
- Semantische Segmentierung ordnet jedem Pixel eines Bildes eine Klasse zu. Das genaue Beschriften der Trainingsdaten ist der größte Aufwand.
- Zero-Shot-Modelle wie das Segment Anything Model (SAM) können beliebige Objekte ausschneiden, auch ohne Training auf genau diese Klasse.
- Grounded SAM kombiniert Objekterkennung per Text mit SAM. SAM 3 von Meta segmentiert seit November 2025 direkt nach kurzen Textbeschreibungen.
- In Medizintechnik und Qualitätsprüfung beschleunigen solche Modelle vor allem die Annotation. Für Spezialbilder braucht es Prüfung und oft Anpassung.
Warum Segmentierung so viel Vorarbeit kostet
Semantische Segmentierung ordnet jedem Pixel eines Bildes eine Klasse zu, etwa Knochen, Gefäß, Kratzer oder Hintergrund. Das liefert ein genaueres Bild als ein Rahmen um das Objekt und ist die Grundlage für Vermessung, 3D-Modelle oder die Prüfung von Oberflächen.
Der Haken liegt in den Trainingsdaten. Für jede Klasse braucht ein klassisches Modell viele Bilder, in denen jemand die Umrisse Pixel für Pixel eingezeichnet hat. Bei apoQlar zeichneten Radiologen und Techniker anatomische Strukturen stundenlang pro Patient von Hand ein, bevor wir eigene Modelle für die automatische Segmentierung trainieren konnten.
Was Zero-Shot-Learning bedeutet
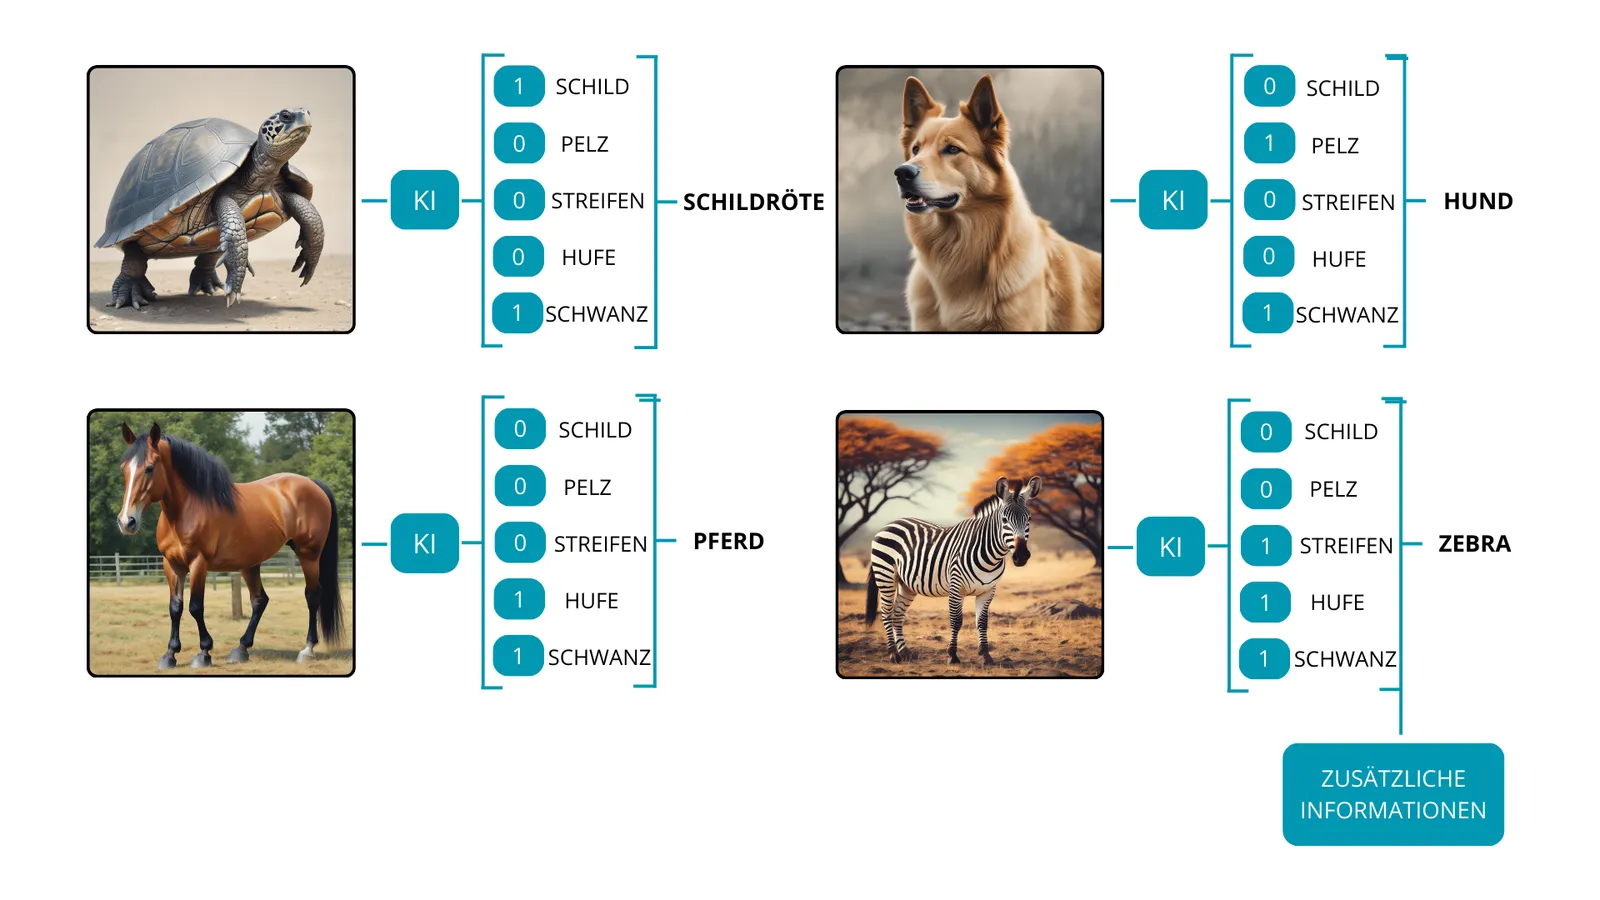
Beim Zero-Shot-Learning erkennt ein Modell Klassen, die im Training nicht vorkamen. Es lernt allgemeine Merkmale und nutzt zusätzliche Informationen, etwa eine Beschreibung. Ein Modell, das Schildkröten, Hunde und Pferde kennt, kann ein Zebra einordnen, wenn es erfährt: ein Pferd mit schwarz-weißen Streifen.
Segment Anything und Grounded SAM
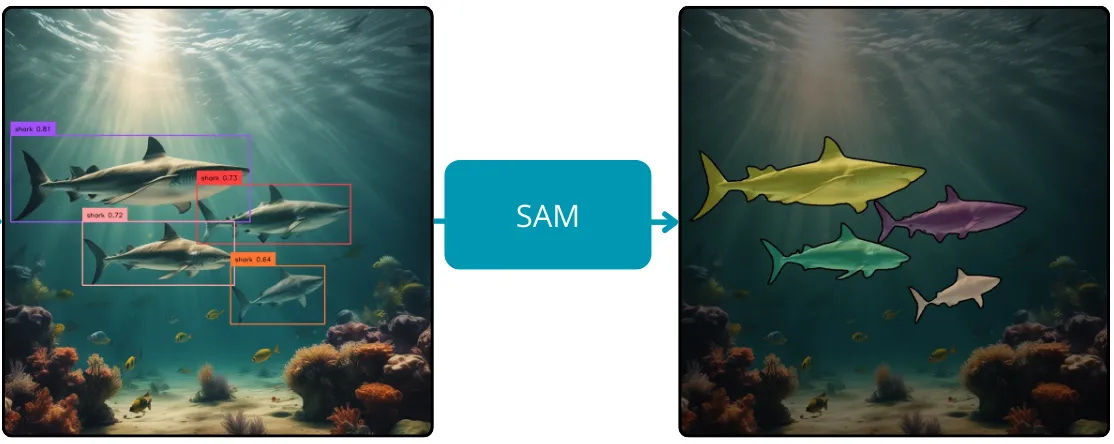
Für die Segmentierung hat Meta mit dem Segment Anything Model (SAM) diesen Gedanken umgesetzt: Das Modell lernt, beliebige Objekte vom Hintergrund zu trennen, statt bestimmte Klassen. Trainiert wurde es mit über einer Milliarde Segmentierungsmasken. SAM erzeugt Masken für das ganze Bild oder gezielt für ein Objekt, das per Rahmen oder Punkt markiert wird.
SAM weiß allerdings nicht, was es ausschneidet. Grounded SAM ergänzt das: Das Erkennungsmodell Grounding DINO findet Objekte anhand eines Textes, etwa „Hai“, und SAM erzeugt für jeden gefundenen Rahmen die genaue Maske.
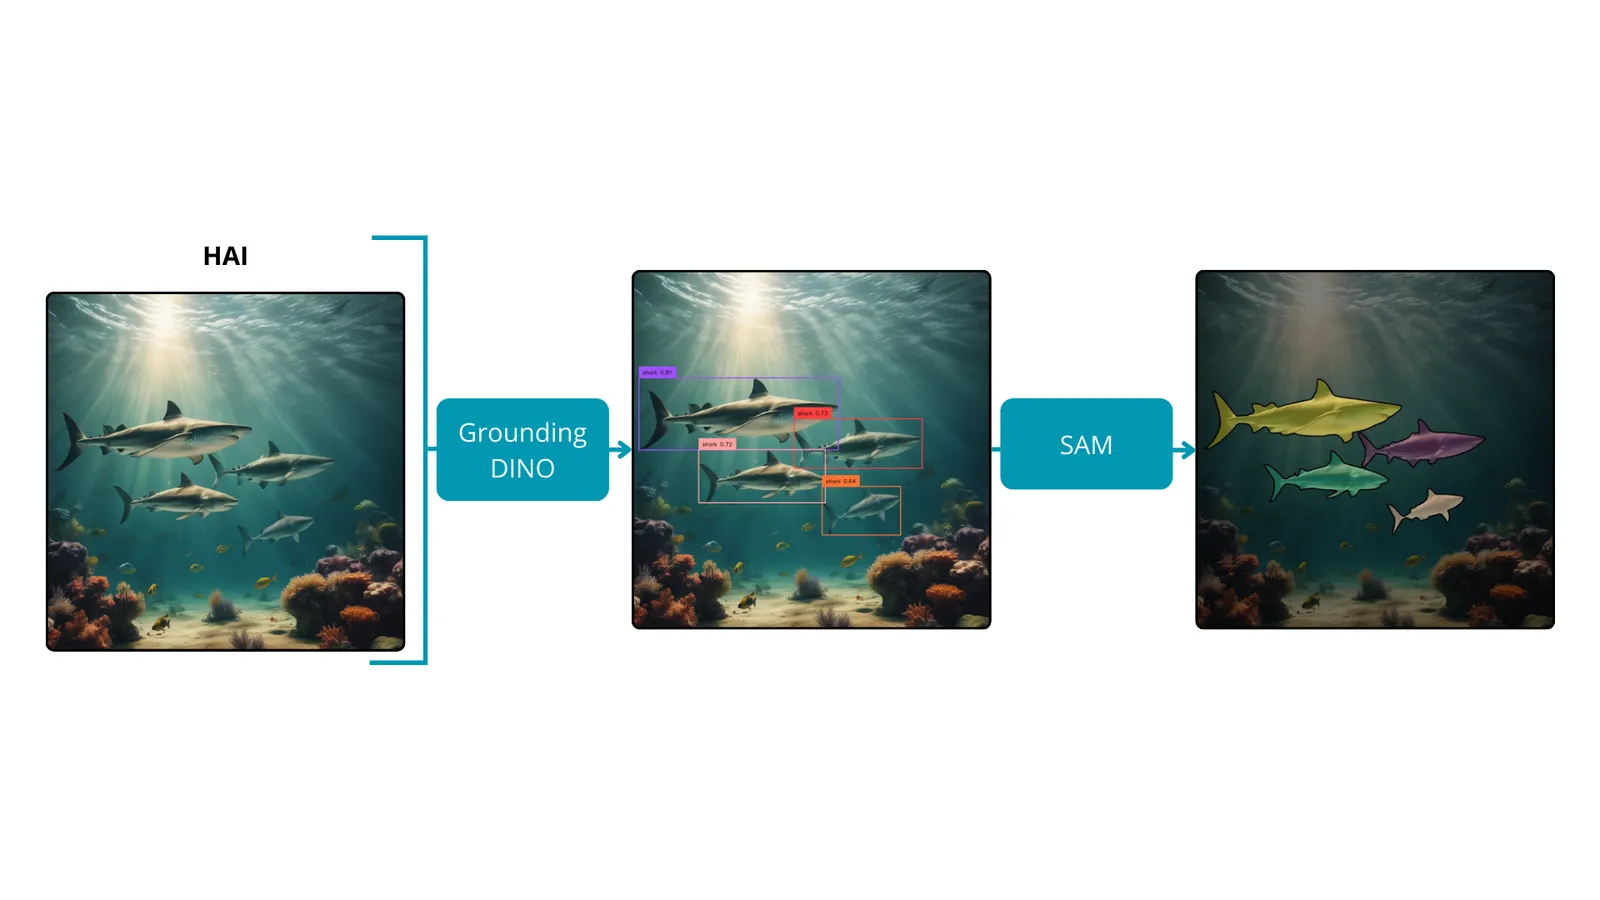
Die Entwicklung ist weitergegangen. SAM 3, im November 2025 von Meta veröffentlicht, nimmt kurze Textbeschreibungen oder Beispielbilder direkt entgegen, segmentiert alle passenden Objekte und verfolgt sie auch in Videos.
Quelle: Meta AI, SAM 3
Was das für Medizintechnik und Qualitätsprüfung bedeutet
| Einsatz | Was Zero-Shot-Segmentierung beiträgt |
|---|---|
| Annotation | Masken werden vorgeschlagen und von Fachleuten nur noch geprüft und korrigiert, statt von Hand gezeichnet |
| Prototypen | erste Ergebnisse auf eigenen Bildern, bevor ein eigenes Modell trainiert wird |
| Qualitätsprüfung | Bauteile, Oberflächen oder Verpackungen per Textbeschreibung auswählen und vermessen |
| Seltene Fälle | neue Objekt- oder Fehlerarten ohne großen neuen Datensatz berücksichtigen |
| Medizintechnik | Vorsegmentierung von Strukturen als Ausgangspunkt für die fachliche Nachbearbeitung |
Der größte Hebel liegt meist in der Annotation: Werden Masken vorgeschlagen und nur noch geprüft, entstehen Trainingsdaten für spezialisierte Modelle deutlich schneller.
Wo die Grenzen liegen
- Spezialbilder: Allgemeine Modelle lernen überwiegend aus Alltagsfotos. MRT, CT, Mikroskopie oder Röntgenbilder sehen anders aus, dort braucht es sorgfältige Prüfung und oft Anpassung.
- Feine Details: Kleine Kratzer, feine Gefäße oder unscharfe Grenzen werden nicht immer zuverlässig erfasst.
- Fachbegriffe: Textbeschreibungen funktionieren gut für alltägliche Begriffe und schlechter für Fachvokabular.
- Verantwortung: In der Medizin und in sicherheitsrelevanter Prüfung bleiben Bewertung und Freigabe bei Fachleuten.
In der Praxis entsteht die beste Lösung oft aus beidem: Zero-Shot-Modelle beschleunigen Annotation und Prototyp, spezialisierte Modelle liefern im Betrieb die nötige Genauigkeit. Wie gut multimodale Modelle in der Qualitätsprüfung abschneiden, zeigt unser Beitrag LLMs in der visuellen Inspektion und Qualitätskontrolle.
Aus der Praxis: apoQlar
Für die OP-Planung mit VSI HoloMedicine® haben wir U-Net-Modelle entwickelt, je eine Variante pro anatomischer Struktur, für MRT und CT. Die Segmentierung, die von Hand Stunden pro Patient dauerte, dauert heute Sekunden.
Segmentierung für Ihre Bilddaten?
Wir prüfen mit Ihnen, ob Zero-Shot-Modelle für Ihre Bilder reichen, wie sie die Annotation beschleunigen und wann sich ein eigenes Modell lohnt.
Prozessanalyse anfragenHäufige Fragen
Ein Ansatz, bei dem ein Modell Klassen erkennt, die in seinem Training nicht vorkamen. Es nutzt dafür allgemeine Merkmale und zusätzliche Informationen wie eine Textbeschreibung.
Ein Segmentierungsmodell von Meta, das gelernt hat, beliebige Objekte vom Hintergrund zu trennen. Es wurde mit über einer Milliarde Masken trainiert. SAM 3 aus dem November 2025 segmentiert auch nach kurzen Textbeschreibungen und in Videos.
Vor allem für schnellere Annotation von Trainingsdaten, für Prototypen auf eigenen Bildern und für seltene Objekt- oder Fehlerarten in der Qualitätsprüfung.
Meist nicht ohne Weiteres. Allgemeine Modelle lernen überwiegend aus Alltagsfotos. Für MRT, CT oder Mikroskopie braucht es sorgfältige Prüfung, oft Anpassung oder spezialisierte Modelle, und die Bewertung bleibt bei Fachleuten.
Aleksandra entwickelt seit 2021 bei theBlue.ai maßgeschneiderte KI-Lösungen mit Schwerpunkt auf agentischen Implementierungen und lokalen LLM-Deployments, die passgenau auf Unternehmensanforderungen zugeschnitten sind. Als AI Engineer hilft sie Organisationen dabei, ihre Prozesse mit produktionsreifen Systemen zu automatisieren, von On-Premise-Open-Source-Modellen bis hin zu RAG-basierten internen Wissensdatenbanken für regulierte Branchen, und erweitert ihr Wissen kontinuierlich in der sich rasant wandelnden Welt der Künstlichen Intelligenz.
In ihren Artikeln teilt sie praktische Erfahrungen aus realen Enterprise-KI-Projekten und zeigt: KI im Unternehmen einzuführen muss nicht kompliziert sein.