Computer vision · Segmentacja
Segmentacja obrazu zero-shot: rozpoznawanie obiektów bez dużych zbiorów danych
Klasyczna segmentacja obrazu wymaga tysięcy ręcznie oznaczonych przykładów dla każdej klasy obiektów. Modele zero-shot segmentują także obiekty, których nie widziały podczas treningu. W MedTech i kontroli jakości oznacza to przede wszystkim szybsze przygotowanie danych treningowych i szybsze prototypy.
 Aleksandra Osztynowicz
Najważniejsze w skrócie
- Segmentacja semantyczna przypisuje klasę każdemu pikselowi obrazu. Najwięcej pracy wymaga precyzyjne oznaczenie danych treningowych.
- Modele zero-shot, takie jak Segment Anything Model (SAM), potrafią wyciąć dowolny obiekt, nawet bez treningu na tej konkretnej klasie.
- Grounded SAM łączy wykrywanie obiektów na podstawie tekstu z SAM. Od listopada 2025 roku SAM 3 od Meta segmentuje obiekty bezpośrednio na podstawie krótkich opisów tekstowych.
- W MedTech i kontroli jakości takie modele przyspieszają przede wszystkim adnotację. Obrazy specjalistyczne wymagają walidacji, a często także dostosowania modelu.
Dlaczego segmentacja wymaga tak wielu przygotowań
Segmentacja semantyczna przypisuje każdemu pikselowi obrazu klasę, na przykład kość, naczynie, rysa albo tło. Daje to dokładniejszy obraz niż ramka wokół obiektu i jest podstawą pomiarów, modeli 3D czy kontroli powierzchni.
Problem tkwi w danych treningowych. Klasyczny model potrzebuje dla każdej klasy wielu obrazów, na których ktoś obrysował kontury piksel po pikselu. W apoQlar radiolodzy i technicy godzinami ręcznie obrysowywali struktury anatomiczne każdego pacjenta, zanim mogliśmy wytrenować własne modele do automatycznej segmentacji.
Na czym polega uczenie zero-shot
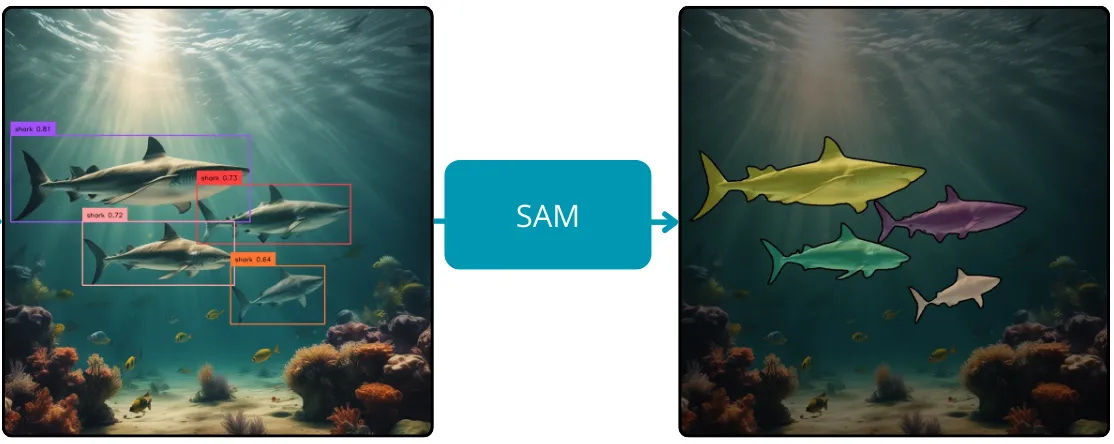
W uczeniu zero-shot model rozpoznaje klasy, które nie pojawiły się w treningu. Uczy się ogólnych cech i korzysta z informacji dodatkowych, na przykład opisu. Model, który zna żółwie, psy i konie, sklasyfikuje zebrę, gdy dowie się, że to koń w czarno-białe pasy.
Segment Anything i Grounded SAM
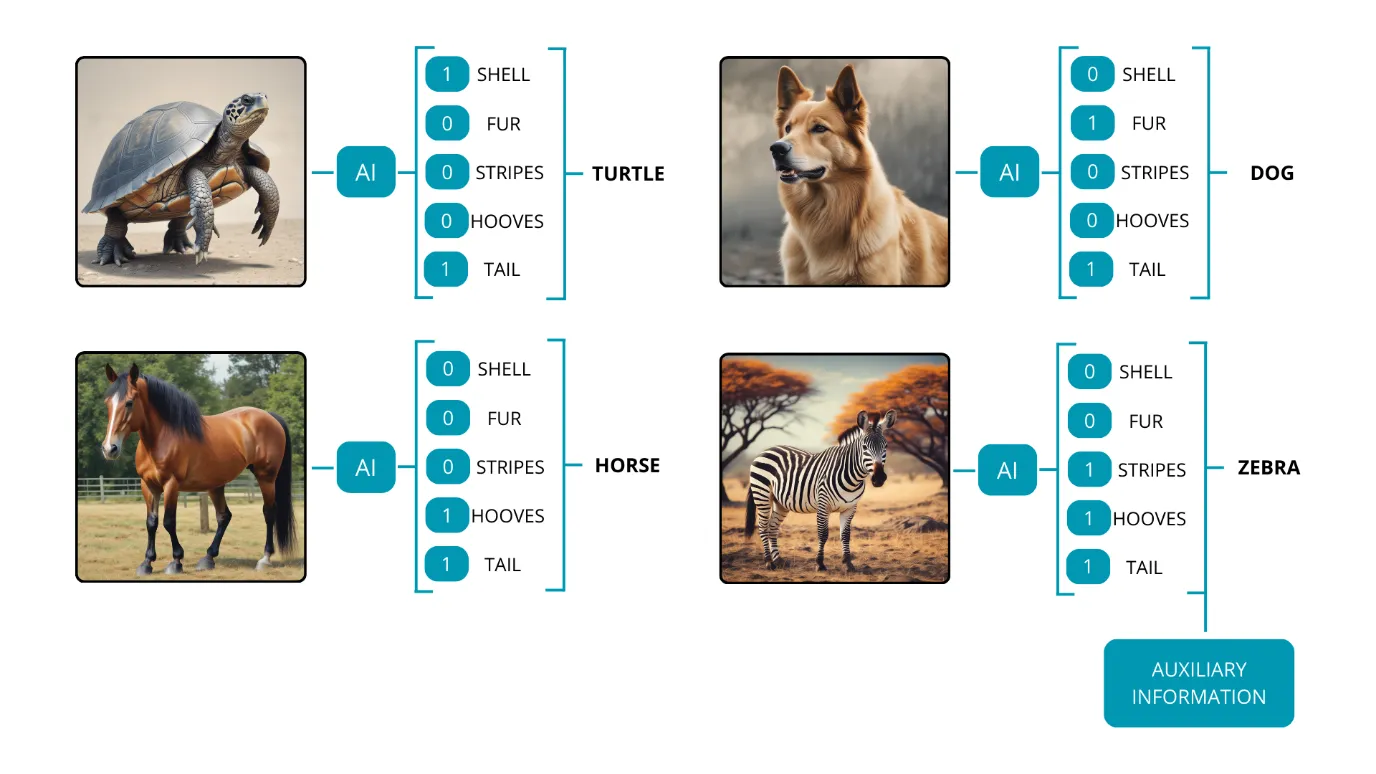
W segmentacji Meta zastosowała tę ideę w modelu Segment Anything Model (SAM): model uczy się oddzielać od tła dowolny obiekt, bez przywiązania do konkretnych klas. Wytrenowano go na ponad miliardzie masek segmentacji. SAM tworzy maski dla całego obrazu albo dla konkretnego obiektu wskazanego ramką lub punktem.
SAM nie wie jednak, co wycina. Tę lukę wypełnia Grounded SAM: model detekcji Grounding DINO znajduje obiekty na podstawie tekstu, na przykład „rekin”, a SAM tworzy precyzyjną maskę dla każdej znalezionej ramki.
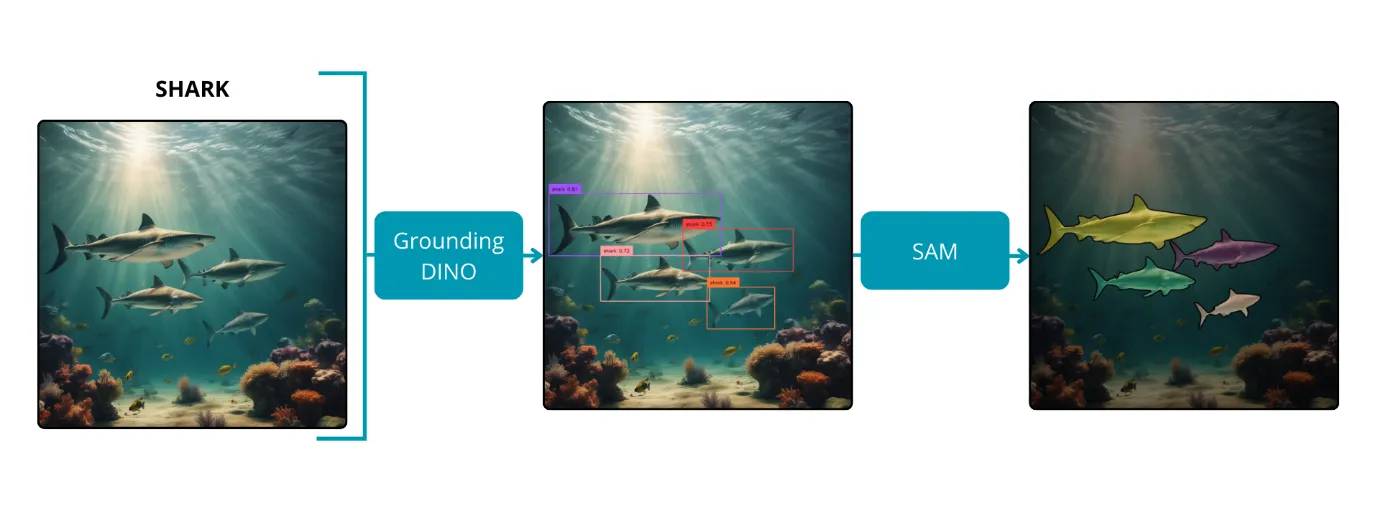
Rozwój poszedł dalej. SAM 3, udostępniony przez Meta w listopadzie 2025 roku, przyjmuje bezpośrednio krótkie opisy tekstowe lub przykładowe obrazy, segmentuje wszystkie pasujące obiekty i śledzi je także w materiale wideo.
Źródło: Meta AI, SAM 3
Co to oznacza dla MedTech i kontroli jakości
| Zastosowanie | Co wnosi segmentacja zero-shot |
|---|---|
| Adnotacja | model proponuje maski, a eksperci tylko je sprawdzają i poprawiają, zamiast rysować ręcznie |
| Prototypy | pierwsze wyniki na własnych obrazach, zanim powstanie dedykowany model |
| Kontrola jakości | wyodrębnianie i mierzenie części, powierzchni lub opakowań na podstawie opisu tekstowego |
| Rzadkie przypadki | obsługa nowych typów obiektów lub wad bez dużego nowego zbioru danych |
| MedTech | wstępna segmentacja struktur jako punkt wyjścia do dopracowania przez ekspertów |
Największe korzyści daje zwykle adnotacja: gdy maski są proponowane i tylko weryfikowane, dane treningowe dla modeli specjalistycznych powstają znacznie szybciej.
Gdzie leżą ograniczenia
- Obrazy specjalistyczne: modele ogólne uczą się głównie na zdjęciach z codziennego życia. Obrazy MRI, CT, mikroskopowe czy rentgenowskie wyglądają inaczej i wymagają starannej walidacji, a często także dostosowania modelu.
- Drobne szczegóły: małe rysy, cienkie naczynia czy rozmyte granice nie zawsze są wychwytywane niezawodnie.
- Terminy fachowe: opisy tekstowe dobrze działają przy słowach potocznych, gorzej przy słownictwie specjalistycznym.
- Odpowiedzialność: w medycynie i w kontroli istotnej dla bezpieczeństwa ocena i ostateczna akceptacja należą do ekspertów.
W praktyce najlepsze rozwiązanie często łączy oba podejścia: modele zero-shot przyspieszają adnotację i budowę prototypów, a modele specjalistyczne zapewniają dokładność potrzebną na produkcji. Jak dobrze modele multimodalne radzą sobie w kontroli jakości, pokazujemy w artykule LLM w inspekcji wizualnej i kontroli jakości.
W praktyce: apoQlar
Na potrzeby planowania operacji w VSI HoloMedicine® opracowaliśmy modele U-Net dla obrazów MRI i CT, po jednym wariancie na każdą strukturę anatomiczną. Segmentacja, która ręcznie zajmowała godziny na pacjenta, trwa teraz kilka sekund.
Segmentacja dla Twoich danych obrazowych?
Sprawdzamy, czy modele zero-shot wystarczą dla Twoich obrazów, jak mogą przyspieszyć adnotację i kiedy opłaca się dedykowany model.
Zapytaj o analizę procesuNajczęściej zadawane pytania
To podejście, w którym model rozpoznaje klasy, które nie pojawiły się w jego treningu. Korzysta z ogólnych cech i informacji dodatkowych, na przykład opisu tekstowego.
To model segmentacji od Meta, który nauczył się oddzielać od tła dowolny obiekt. Wytrenowano go na ponad miliardzie masek. SAM 3 z listopada 2025 roku segmentuje też na podstawie krótkich opisów tekstowych i w materiale wideo.
Przede wszystkim do szybszej adnotacji danych treningowych, prototypów na własnych obrazach oraz obsługi rzadkich typów obiektów lub wad w kontroli jakości.
Zwykle nie w gotowej postaci. Modele ogólne uczą się głównie na zdjęciach z codziennego życia. Obrazy MRI, CT czy mikroskopowe wymagają starannej walidacji, często dostosowania lub modeli specjalistycznych, a ocena pozostaje w rękach ekspertów.
Aleksandra od 2021 roku tworzy w theBlue.ai dedykowane rozwiązania AI. Specjalizuje się w systemach agentowych i wdrożeniach lokalnych modeli LLM dopasowanych do potrzeb firm. Jako AI Engineer pomaga organizacjom automatyzować procesy za pomocą systemów gotowych do pracy produkcyjnej: od modeli open source działających on-premise po wewnętrzne bazy wiedzy oparte na RAG dla branż regulowanych. Na bieżąco poszerza swoją wiedzę w szybko zmieniającym się świecie sztucznej inteligencji.
W swoich artykułach dzieli się doświadczeniem z prawdziwych projektów enterprise AI i pokazuje, że wdrożenie AI w firmie nie musi być skomplikowane.